
Anthropic 在 10 月 7 日发布了 Claude Haiku 5.5,把小模型的短上下文价格降到了 GPT-6 Luna 同一档。官方公布的几项对照基准中,Haiku 的成绩也更高。不过,这场比较最容易被忽略的差别是:输入一旦变长,两家的计费规则就分开了。
本文依据截至 2026 年 10 月 8 日核验的官方资料整理,没有自行调用两款模型进行对照实测。我们更关心一个实际问题:你的日常任务交给哪款模型,才能在可接受的质量下减少总成本,包括重试和转交大模型的费用。
Haiku 5.5 这次更新了什么?
Haiku 5.5 模型文档列出了 100 万 token 上下文、最高 12.8 万 token 输出,以及模型 ID claude-haiku-5-5。它主要面向分类、信息提取、任务分流和子 Agent 等调用量大、对延迟敏感的工作。
OpenAI 在 GPT-6 Sol 与 Luna 发布说明中,也把 Luna 放在任务范围明确、需要大量重复调用的位置。客服工单、文档处理、Agent 中的小任务,正是两款模型值得放在一起比较的地方。
例如,文档助手可以先让小模型找出相关段落,再让大模型组织完整答案。这是可尝试的设计思路;它能否可靠找到资料,仍需要用你的文档验证,不能由产品定位直接推导。
API 价格相同,但低价档的范围不同
下表采用标准 API 处理价格,单位为美元/每百万 token,不包含 Batch 折扣、区域附加费和单独计费的工具。
| 模型与输入长度 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Haiku 5.5,输入不超过 10 万 token | $0.10 | $0.50 | $0.01 |
| Haiku 5.5,输入超过 10 万 token | $0.50 | $2.50 | $0.05 |
| GPT-6 Luna,输入不超过 27.2 万 token | $0.10 | $0.50 | $0.01 |
| GPT-6 Luna,输入超过 27.2 万 token | $0.20 | $0.75 | $0.02 |
来源:Anthropic 价格文档、OpenAI API 价格文档。达到高价档后,按相应费率计算这次请求,不能只给超出门槛的部分加价。模型装得下多少内容,与多少内容能按最低单价处理,是两个问题。
用两个假设预算可以看出差别。以下均假设输入未命中缓存,输出数量为实际计费数量:
- 1 万次分类请求:每次输入 2,000 token、输出 200 token,两款模型都是 3 美元,包含 2 美元输入和 1 美元输出。
- 一次长文档请求:输入 15 万 token、输出 2,000 token,Haiku 为 0.08 美元,Luna 为 0.016 美元。前者已经跨过高价门槛,后者仍在低价档。
这些是按假设计数计算的例子,不是实测账单。同一份文本在不同模型里可能被切成不同数量的 token;推理消耗、重试和工具调用也会改变最终费用。预算对比应使用各自记录的计费数量。
“平均便宜 75%”应该怎样理解?
Anthropic 发布说明估算,Haiku 5.5 相比 Haiku 4.5 的平均任务成本下降约 75%。按每 token 单价看,10 万以内下降 90%,超过 10 万下降 50%;平均任务成本还考虑了 token 消耗的变化。它比较的是上一代 Haiku,不是在说比 Luna 便宜 75%,也不保证你的每次请求都节省这个比例。
官方 Benchmark:哪些成绩领先?
下面是从 Anthropic 官方真实评测 UI 截取的图,核查日期为 2026 年 10 月 8 日,保留了原始标签和评测条件。点击图片可查看高清原图。这些是供应商公布的评测,不是 Mengbi 自行实测。
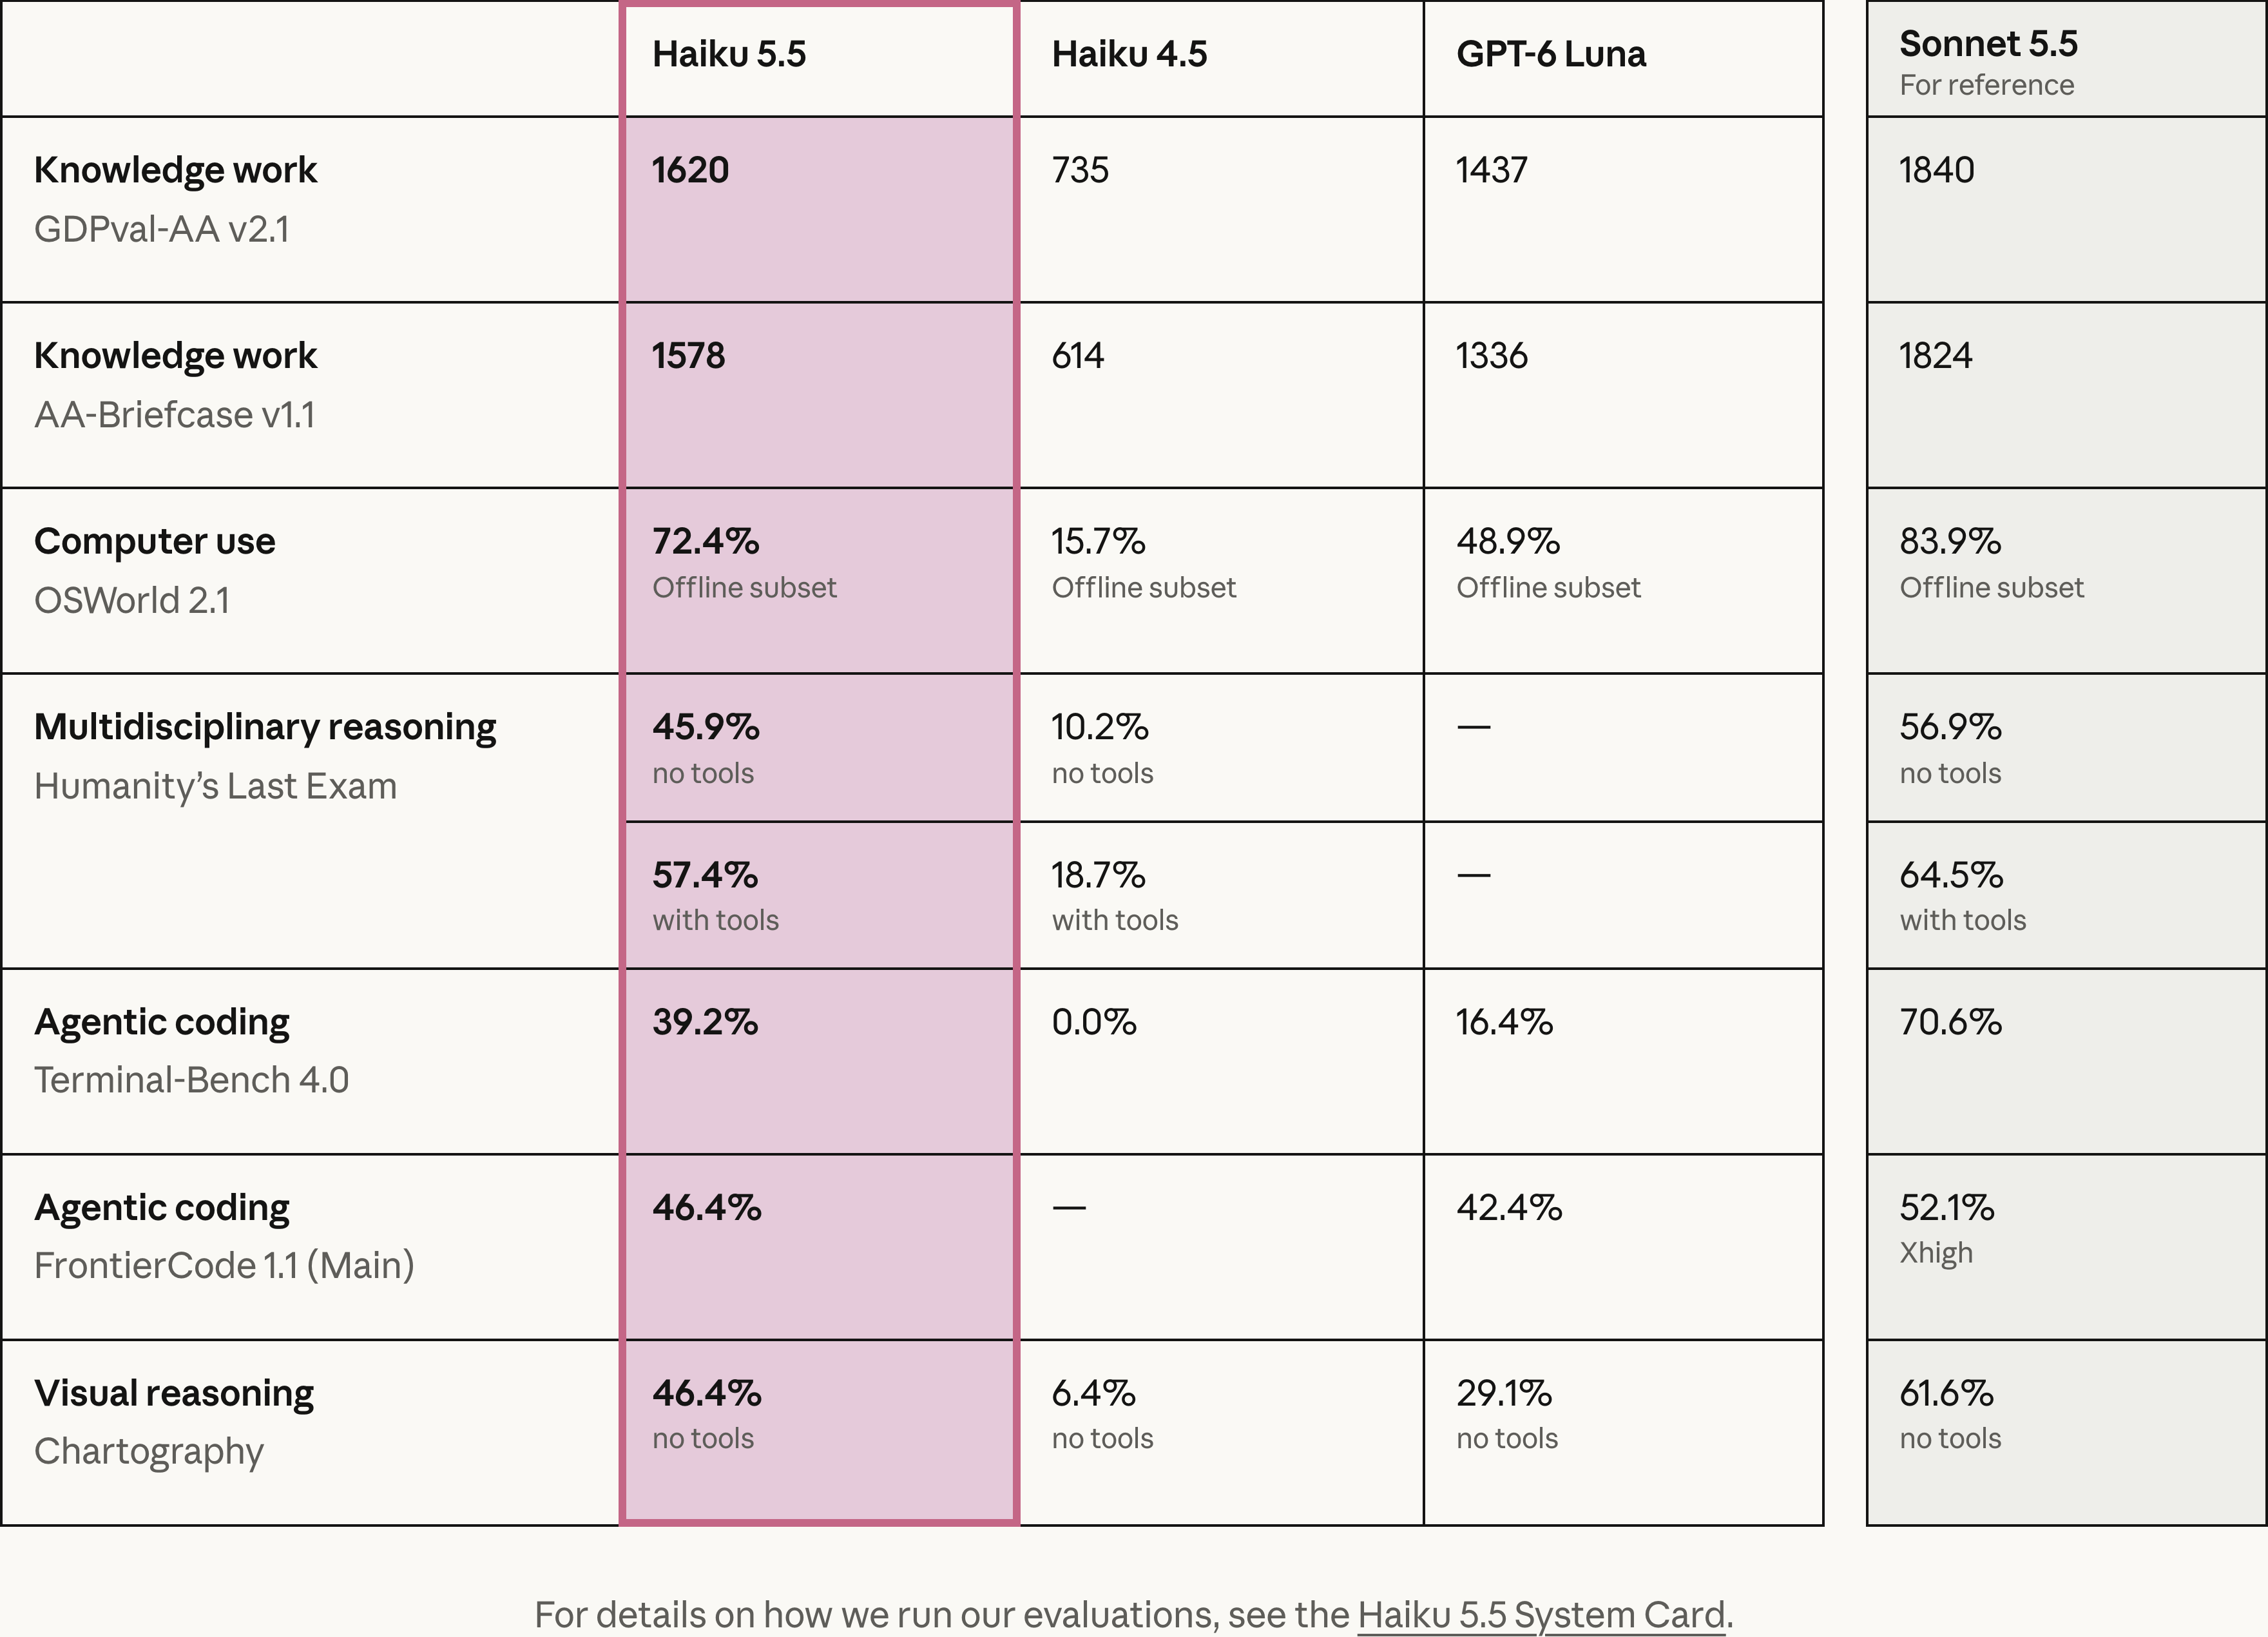
来源:Anthropic Haiku 5.5 发布说明的 Performance 部分。原表区分了离线子集、是否使用工具,以及 Sonnet 的参考成绩;评测方法见其链接的 Haiku 5.5 System Card。
下表来自同一份 Anthropic 官方对照表。每行分别比较,数值越高越好;两项知识工作分数不是准确率百分比。
| 评测 | Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| GDPval-AA v2.1,知识工作 | 1620 | 1437 |
| AA-Briefcase v1.1,知识工作 | 1578 | 1336 |
| OSWorld 2.1,离线子集 | 72.4% | 48.9% |
| Terminal-Bench 4.0,Agent 编程 | 39.2% | 16.4% |
在这些评测中,Haiku 的成绩更高。它们不能直接证明中文写作、响应速度或你的工具调用流程也会全面领先。尤其是 OSWorld 的离线子集,不能解释成操作任意网站都有 72.4% 的成功率。
选型时要把运行框架、工具、推理档位和任务分布一起看。更高推理预算下的成绩,不能代替最低成本档的表现。官方对照适合帮助你决定下一步测试谁;真正切换流量,还要验证产品实际发出的请求。
OSWorld:最高成绩对应更高的推理预算
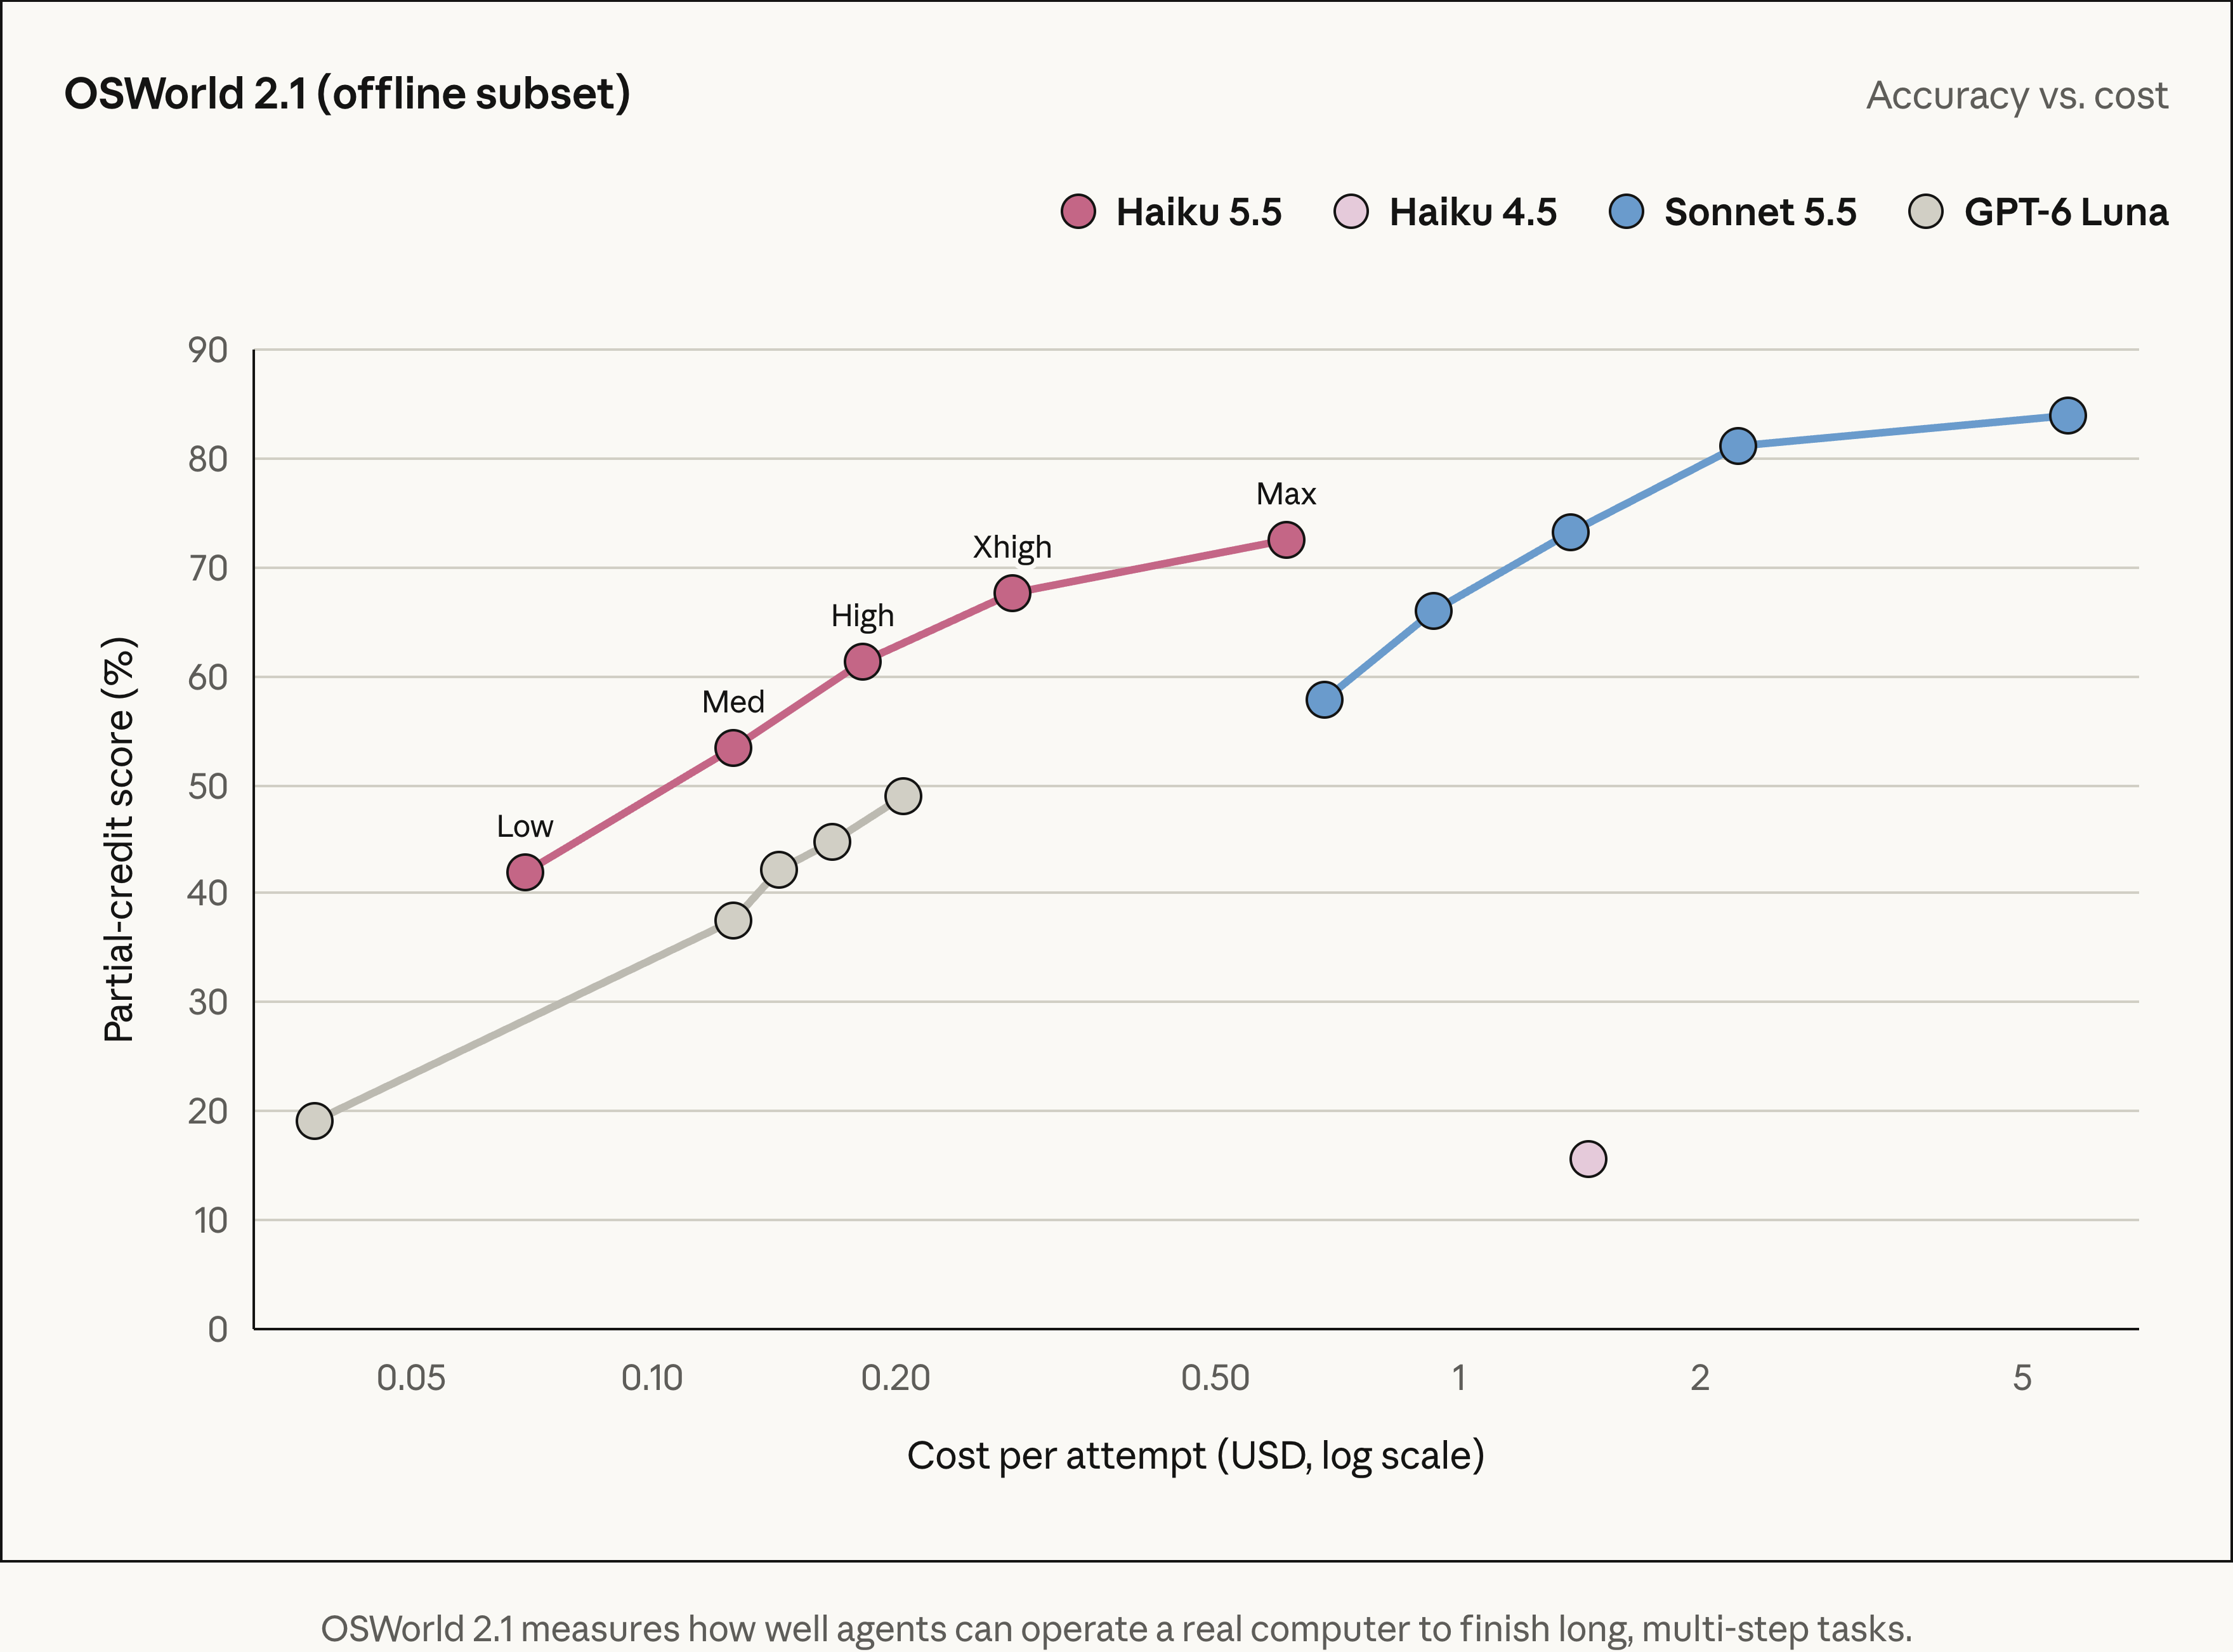
来源:Anthropic 交互图表的「Computer use: OSWorld」标签页,保留全部四款模型,评测范围是 OSWorld 2.1 离线子集。
纵轴是 partial-credit score(部分得分),不能当成完整完成请求的比例。官方 UI 中,Haiku 从 Low 档的 42.0% 提升到 Max 档的 72.4%,每次尝试成本也从约 0.07 美元升到 0.61 美元。Luna 图中的最高点是 48.9%,成本约 0.20 美元。因此,两个最高成绩对应的花费并不相同;只看最后一个分数,会漏掉整条成本曲线。
GDPval-AA:分数刻度和成本要一起读
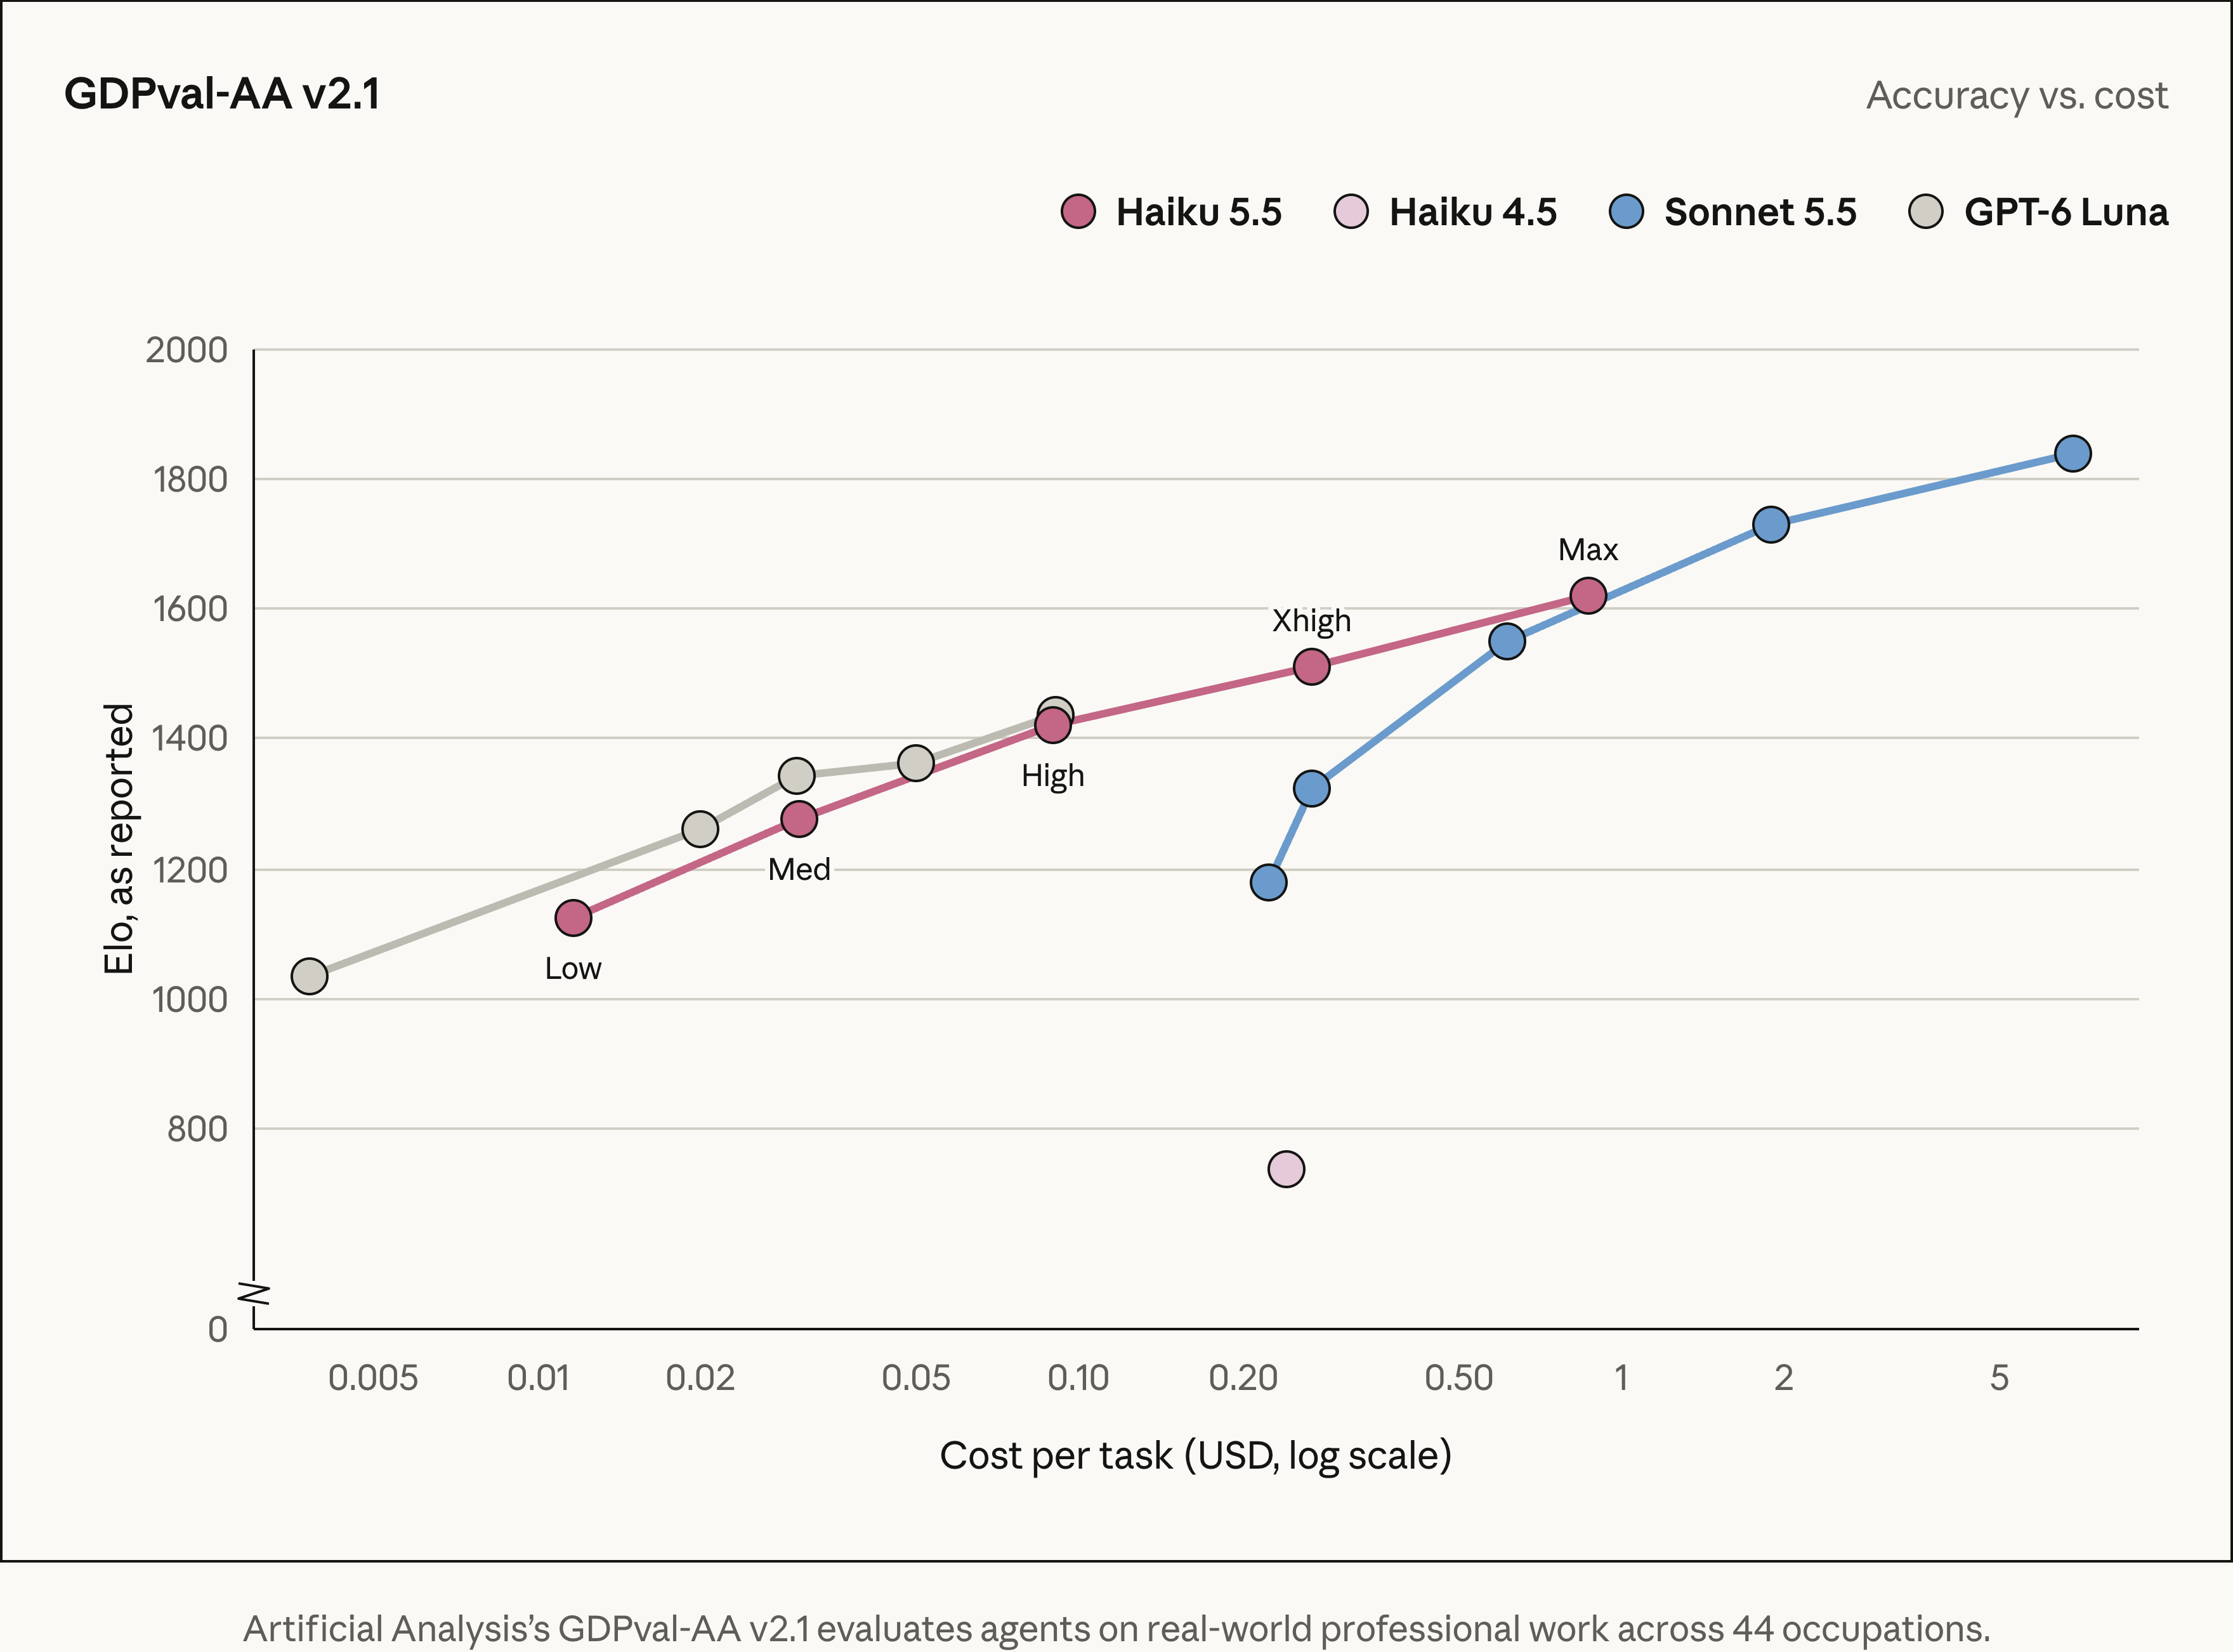
来源:Anthropic 交互图表的「Knowledge work: GDPval-AA」标签页。纵轴标为「Elo, as reported」,并保留断轴标记;横轴是美元计价的每项任务成本,采用对数刻度。
这项评测覆盖 44 种职业的实际工作任务。Haiku 的曲线随 effort 改变,不能把 1620 分理解为每次默认请求都能达到的结果。选型时应在自己能接受的预算附近比较曲线,再用本行业任务验证这种排序是否成立。
Terminal-Bench:别漏掉缓存价格条件
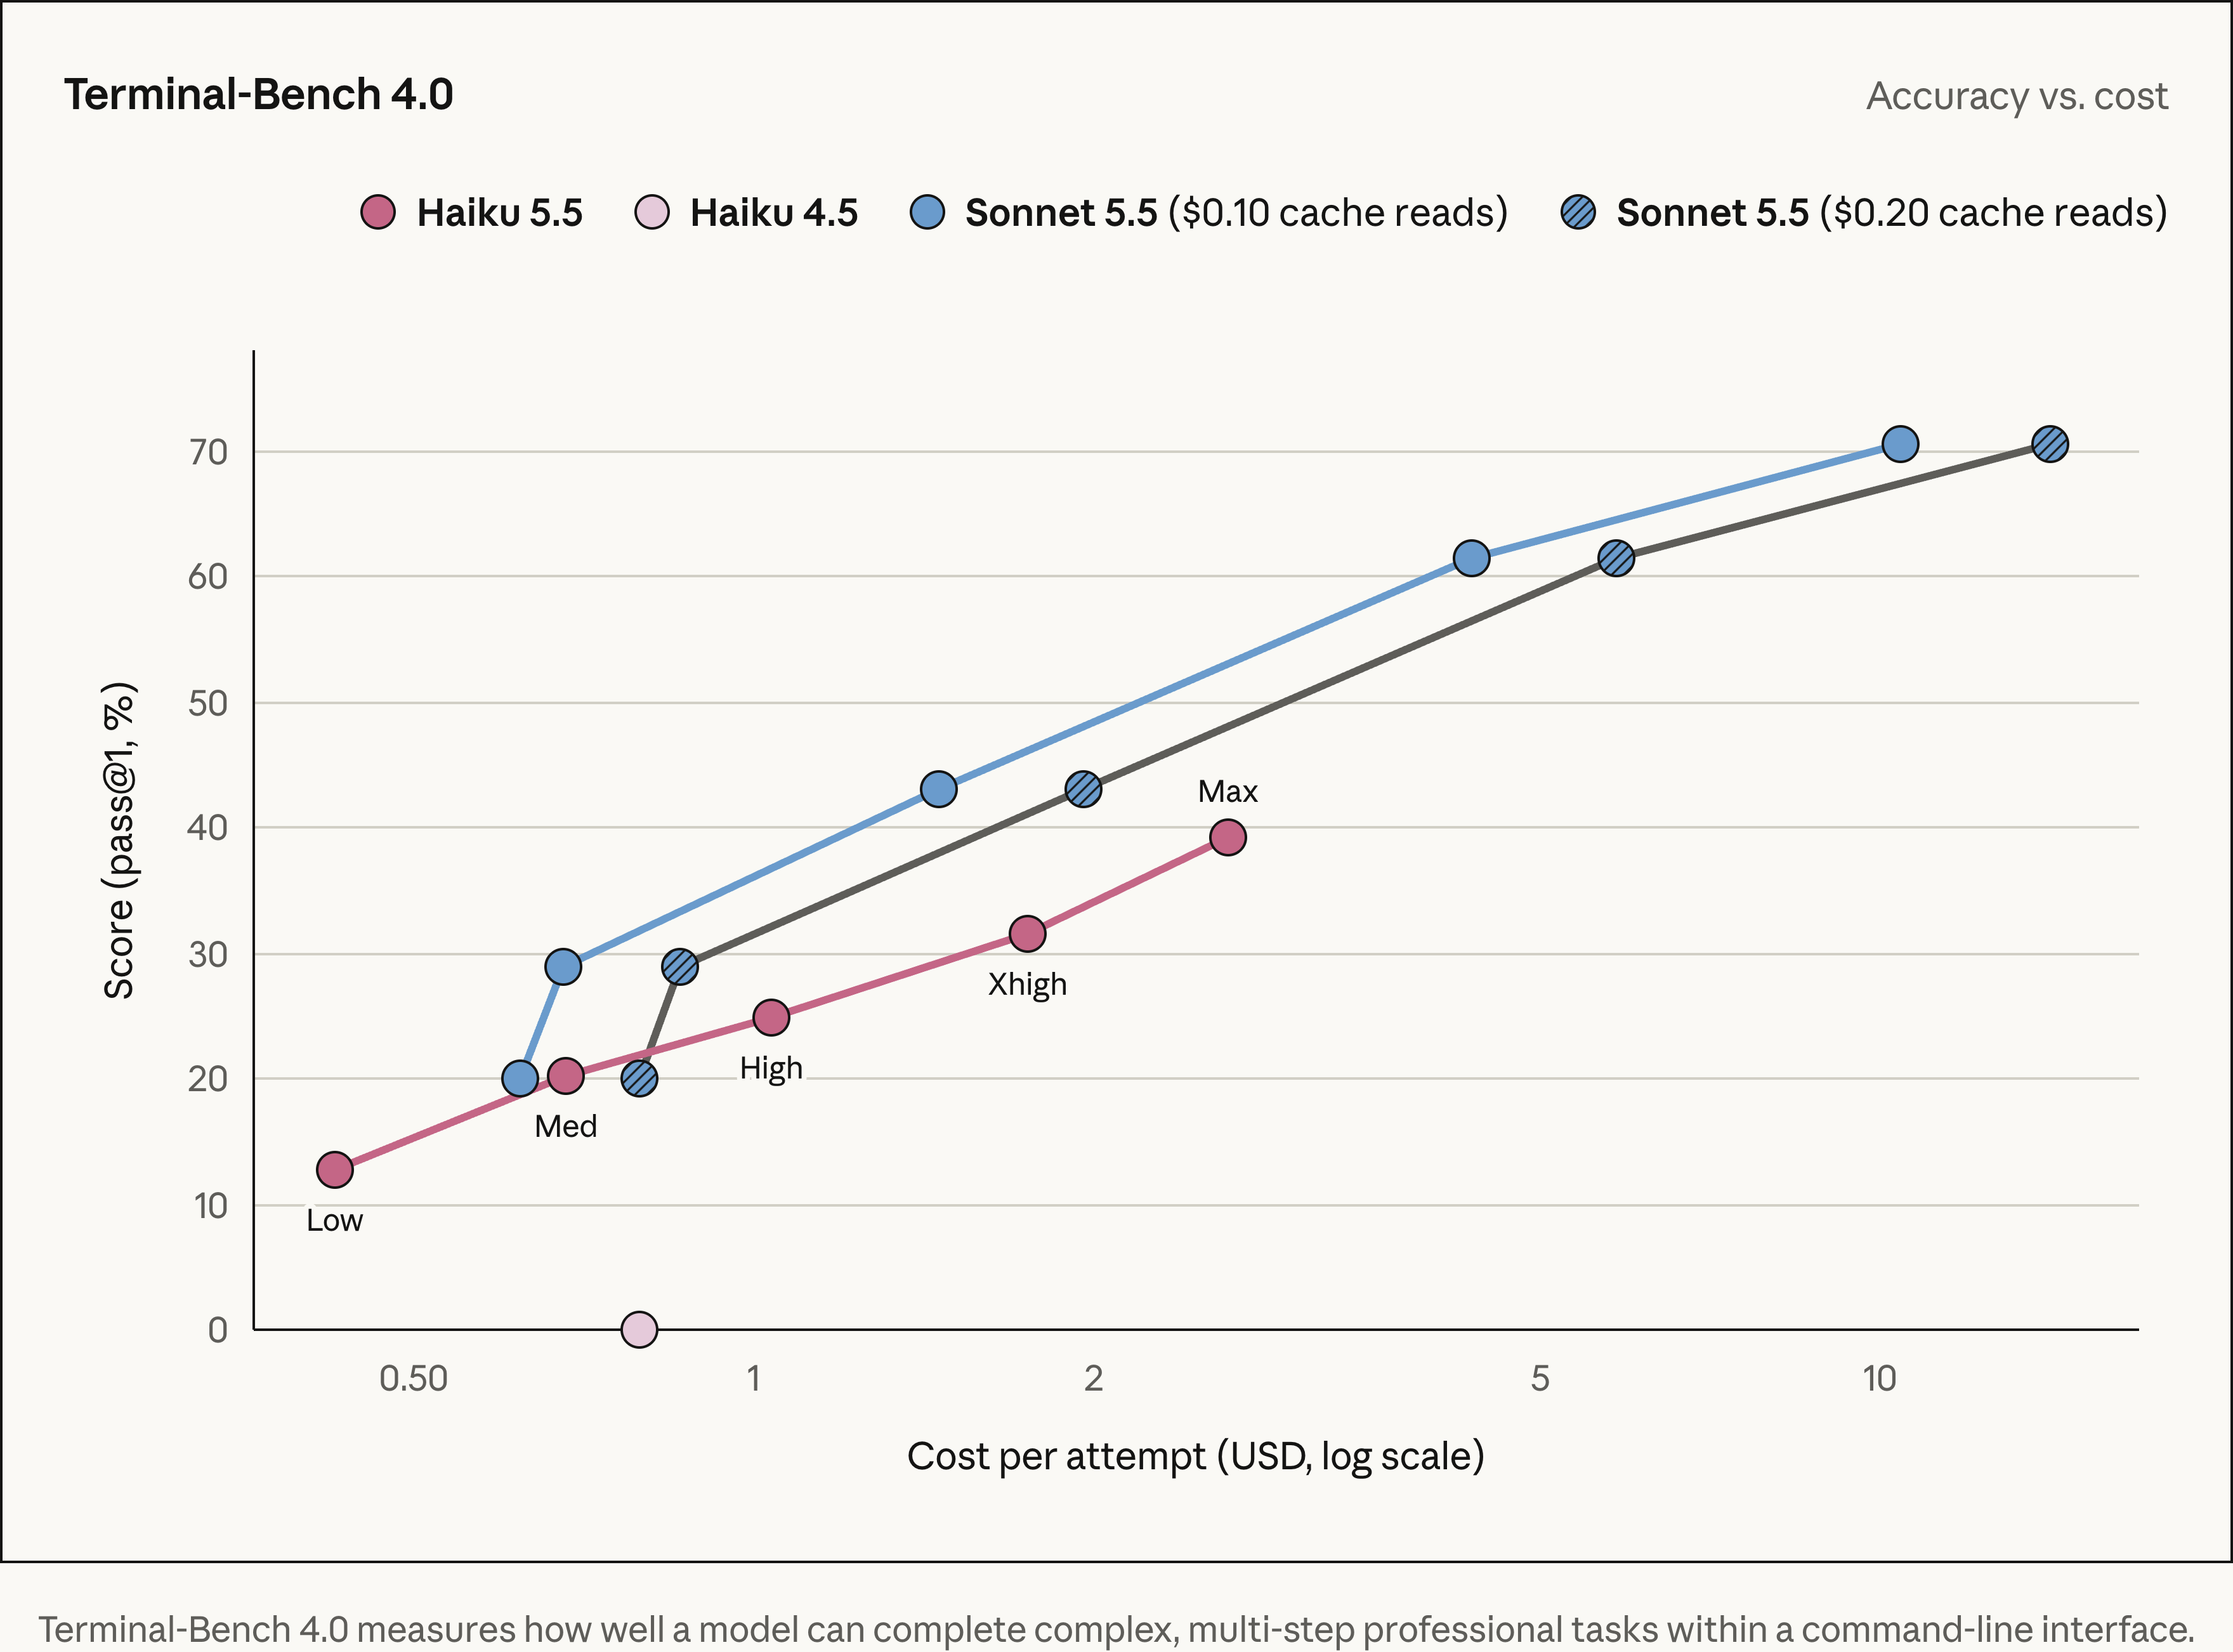
来源:Anthropic 发布说明的 Further updates 部分。图中包含 Haiku 5.5、Haiku 4.5,以及缓存读取单价分别为每百万 token 0.10/0.20 美元的 Sonnet 5.5,没有 Luna 曲线。
纵轴是 pass@1 得分。两条 Sonnet 曲线展示了缓存读取降价如何在相同能力下移动成本位置,也说明 Agent 预算不能只看模型名称,还要看缓存命中。Haiku 与 Luna 的编程成绩对照仍应看上面的官方表,不能把这张图当成 Luna 的测试结果。
推理档位和迁移:不能只改模型名称
Haiku 5.5 支持调节推理 effort。官方 effort 文档给出的默认档位是 medium,请求字段为 output_config.effort。降低档位可以减少 token 消耗,但可能损失能力;它控制模型行为,不是严格的费用上限。
旧请求中的参数也要检查。Haiku 模型文档建议省略 temperature、top_p 和 top_k,因为非默认值会返回 400 错误。新的 tokenizer 也意味着旧版 token 预算需要重新核对。
Luna 的接入条件不同。OpenAI 模型文档要求内置工具与函数调用使用 Responses API;通过 Chat Completions 做函数调用时,reasoning_effort 必须设为 none。两家模型都便宜,不代表请求格式可以直接互换。
如果业务同时要求结构化 JSON 和调用工具,还应参考 Haiku 提示词指南中的 adaptive thinking 或工具选择建议,把这种组合纳入迁移测试。
哪款更值得先试?
已经使用 Claude 的短任务,可以先评估 Haiku 5.5。沿用供应商通常能减少接入工作,但从 4.5 切换前,仍要验证参数、工具行为和输出。
已经使用 OpenAI 的工作流,可以继续把 Luna 作为基线。起步价格持平之后,切换供应商需要由更好的完成质量或更低的总任务成本来支撑。
输入在 10 万到 27.2 万 token 之间的任务,应优先验证 Luna 的计费优势。也可以尝试先筛选相关段落再调用模型,但减少输入的前提是没有丢掉回答所需的信息。
需要长时间修改代码的任务,应评估整个 Agent 流程。把明确的检索、检查交给小模型,把更广泛的修改交给能通过你自己的代码评测的模型。Mengbi 的 AI 编程 Agent 对比讨论了模型之外的工具选择。
建议用同一组人工标注任务,记录完成质量、JSON 格式失败、漏调用工具、延迟分布、重试次数和升级大模型的费用。业务涉及中文或混合语言,就把这些输入放进测试。最后比较的是每个合格结果的成本;单次回答便宜,却要多补一次调用,整条流程可能更贵。
常见问题
Haiku 5.5 比 GPT-6 Luna 更便宜吗?
标准处理下,两者的短上下文输入、输出单价相同。Haiku 超过 10 万输入 token 就进入高价档,Luna 的门槛为 27.2 万。实际费用还取决于 token 切分、缓存和重试。
Haiku 5.5 可以替代 Sonnet 或 Opus 吗?
如果你的测试证明它能完成某个明确任务,就可以考虑交给它。小模型基准进步,并不能证明它能接手大模型承担的所有复杂工作;对无法可靠完成的任务,仍应保留升级路径。
接入时只替换模型 ID 就够了吗?
还要检查请求参数、推理设置、token 预算和工具行为。跨供应商迁移则需要使用相应 API 格式,上线前验证完整请求与响应流程。