
让模型通宵改一个已有仓库,第二天能留下多少?Google 给 Argon 的任务是优化约 20.5 万行 Python 代码。它跑了 11 小时,提出六项改动,维护者最终留下两项。完整 158 轮任务的框架耗时从 65.6 秒降到 56.1 秒;最显眼的“快约 40%”,指的是长会话准备开销。
这比一句“编程能力更强”更能说明问题:有实际收益,也有需要删掉的错误方案。下文先看公开代码、前后数据和机器人演示,再讲怎么接入。这些是 Google 公开的测试与演示,配图保留原始结果和标注;本文没有把它们当作本站亲测。
Google 在 2026 年 10 月 13 日扩大开放 Argon,Gemini App 支持 Pro 和 Ultra。我们在 10 月 1 日的 Argon 评测讨论过跑分;本文补上开放后的案例与接入条件,资料核查日期为 10 月 14 日。
代码案例:11 小时优化 ADK,哪些改动真的合并了?
Google 的 ADK 工程记录没有让 Argon 从零造一个演示 App,而是要求它减少现有 Agent 框架的运行开销,同时保持公开 API 和发给模型的请求不变。
第二轮运行前,团队把仓库规范放进 .agents/skills,用 Antigravity 的 /goal 保留长任务目标。Argon 先跑基线,再追踪跨文件调用,完成后运行了 16,892 项单元测试。最终合并的 公开提交 1754b3e涉及 22 个文件,任何人都能查看改动和 benchmark 数字。
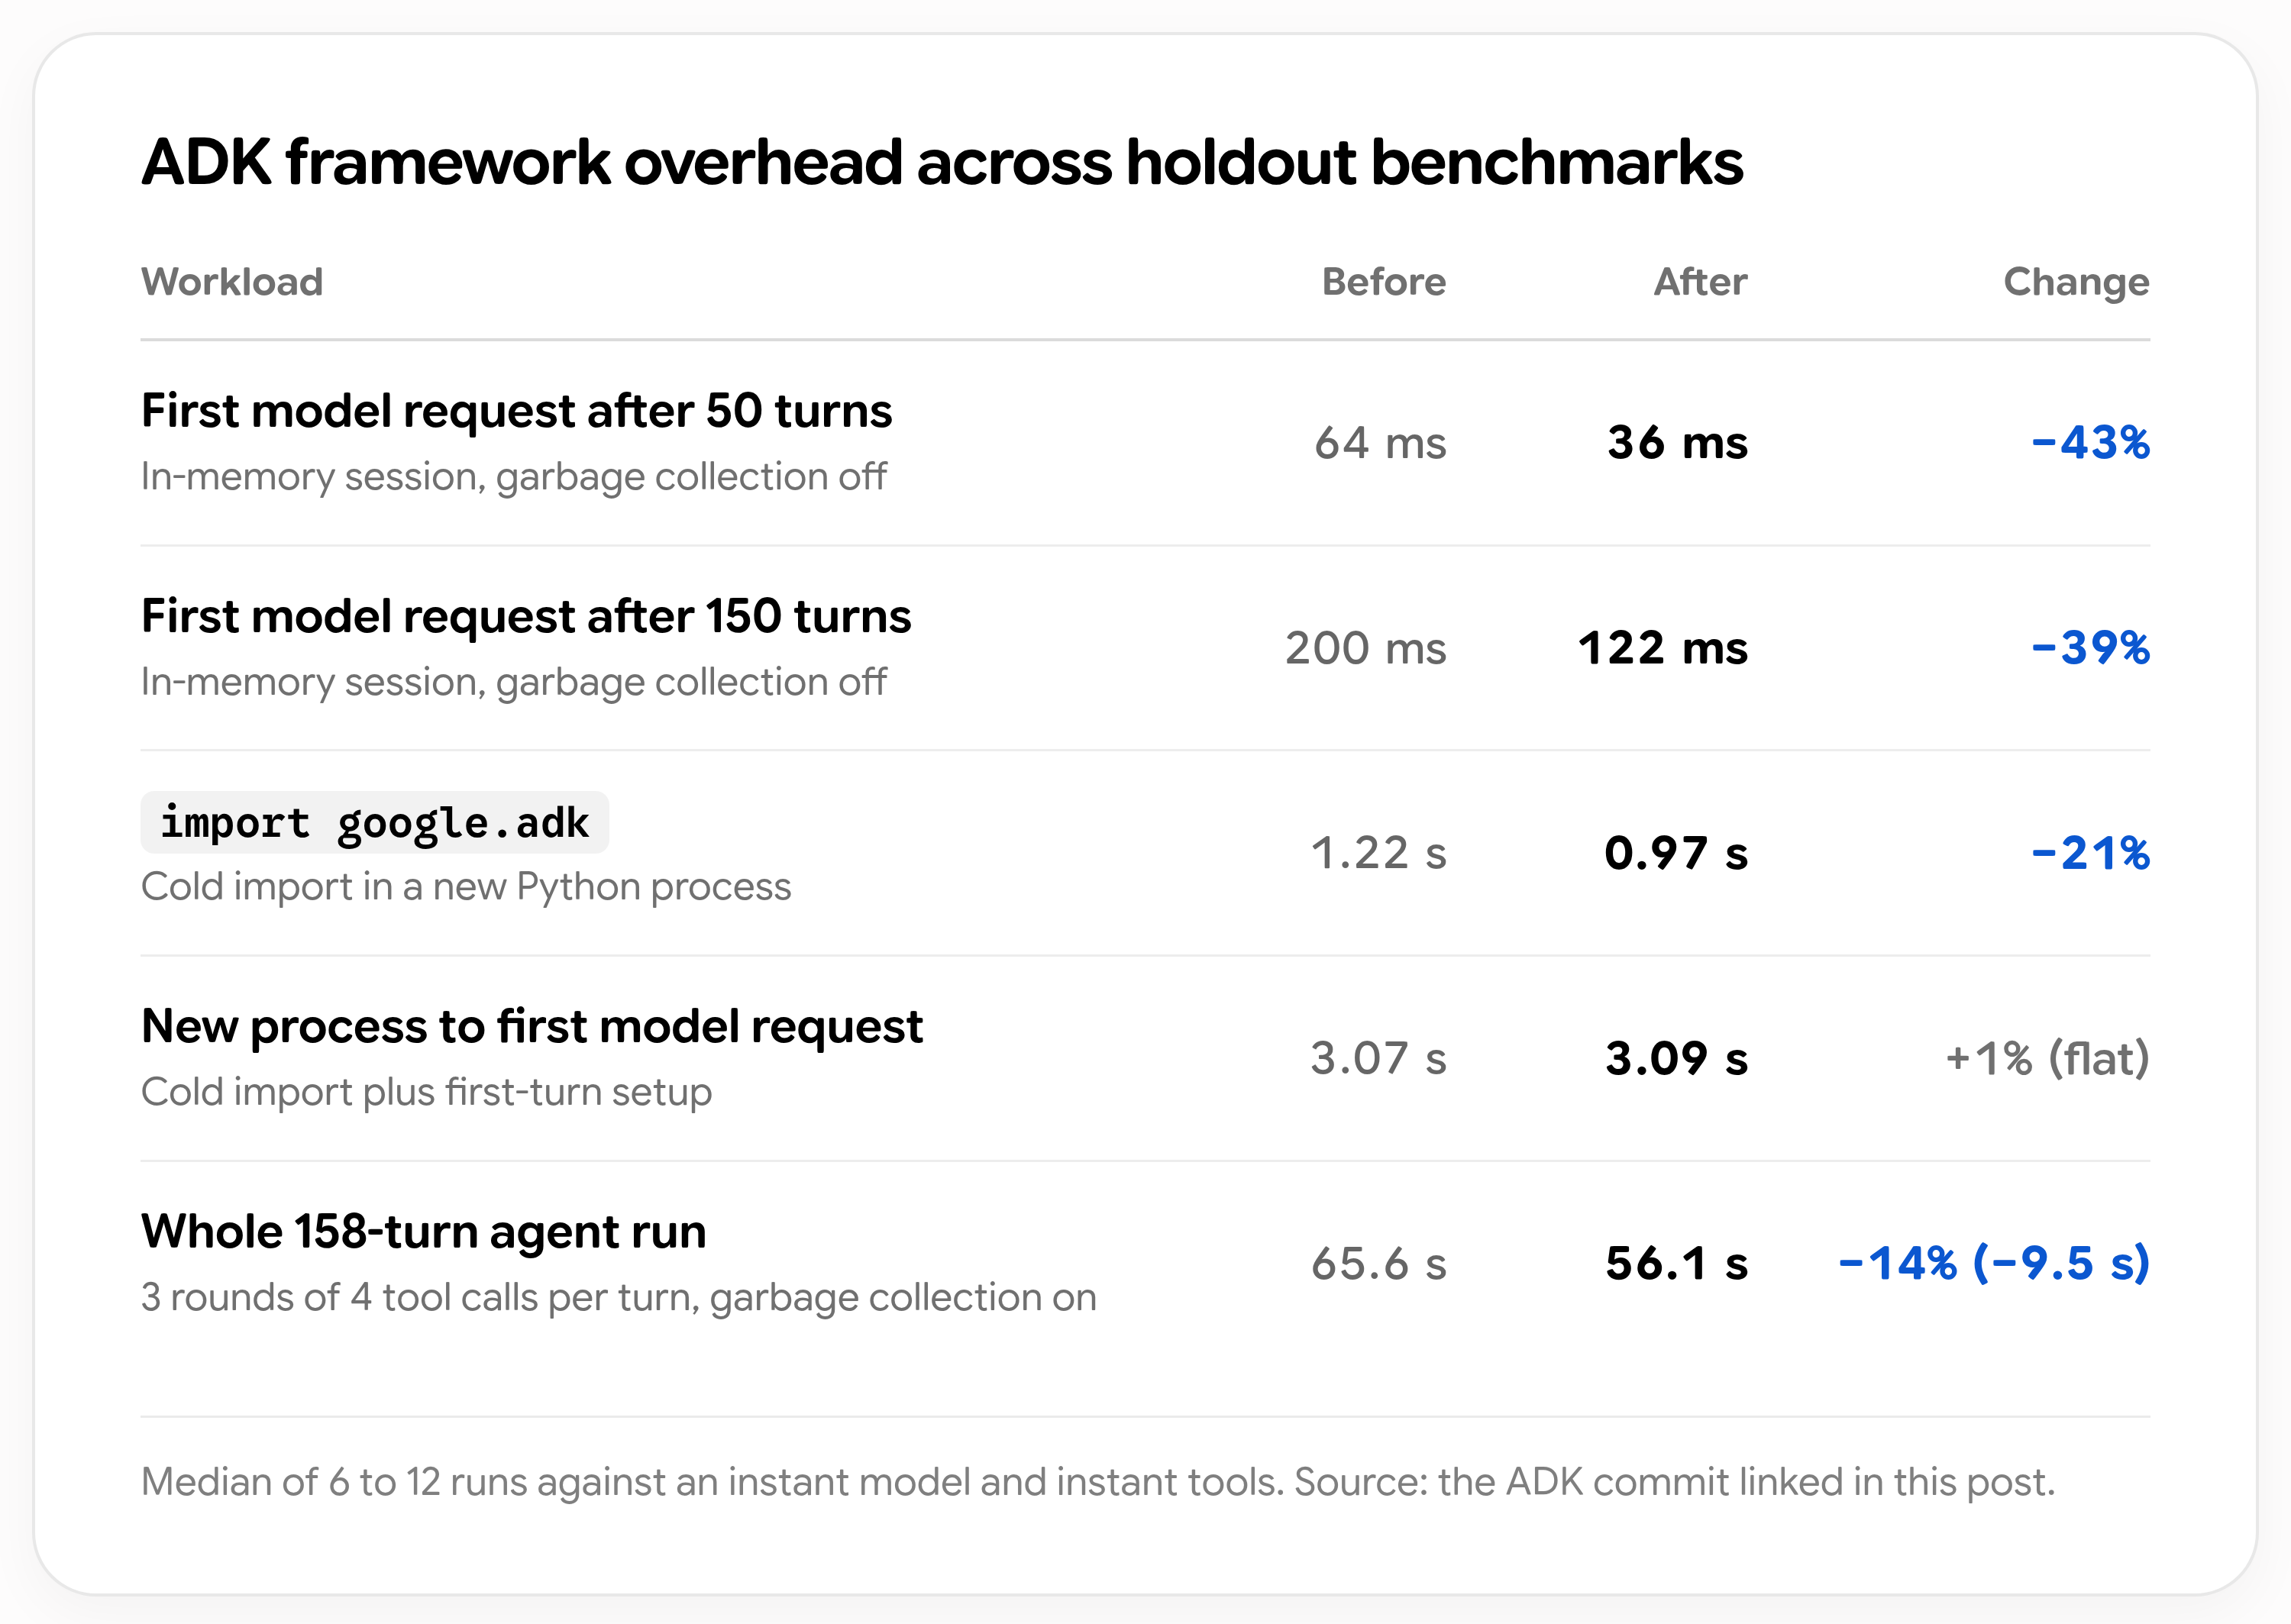
图:Google 官方结果原图,数字与公开提交一致;点图可看大图。案例与测试方法。
合并的两项修正很具体。读取内存会话时,旧代码先深拷贝整段历史,再筛选所需事件;新代码先筛选,只复制要返回的部分。导入 ADK 时,原先会把音视频、遥测和 Web 服务模块一并载入;新代码延后加载,并保留测试代码需要 mock 的公开属性。
测试测的是框架开销。 Google 用立即返回的模型和工具隔离网络与推理时间,每项取 6–12 次运行的中位数。50 轮与 150 轮历史后的准备时间分别从 64→36 ms、200→122 ms;这两项关闭了垃圾回收。完整 158 轮运行保持垃圾回收开启,从 65.6→56.1 秒,约减少 14%。新进程到首个模型请求则为 3.07→3.09 秒,几乎没改善:延后的模块还是要在第一次使用时加载。
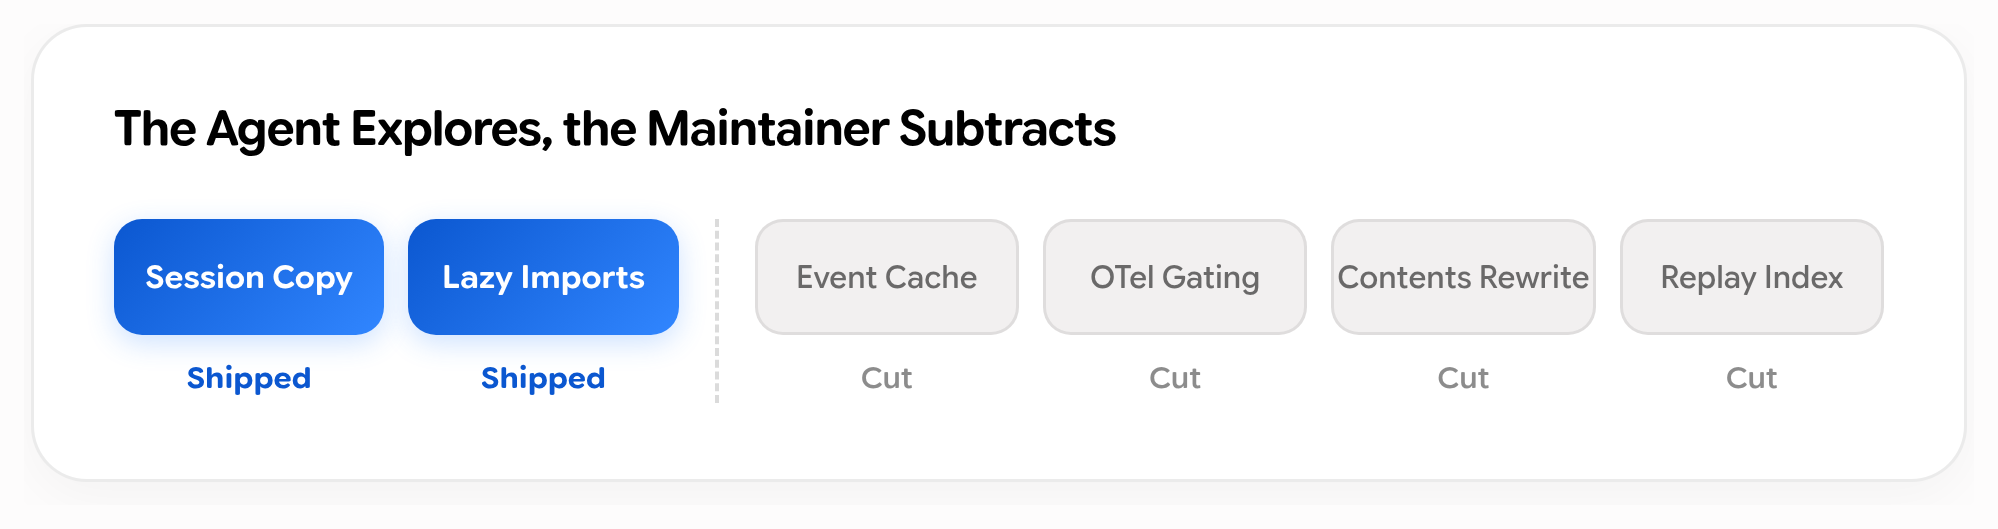
图:Google 公开的六项提案审查结果。两项合并,四项删除;原图来自同一工程记录。
被删的方案更能检验“自动完成”这句话:事件缓存可能因内存地址复用读到过期数据;遥测优化访问了第三方库的私有属性;另外两项收益只出现在合成测试里,或增加复杂度却没改善留出测试。更早的直接删导入方案还导致 25 个内部测试目标失败,尽管开源测试全部通过。
这个案例支持“把模型交给明确的优化目标”,也说明验收不能止于绿色测试。维护者检查了兼容性和独立 workload,才把结果收敛到两项改动。想选执行这类任务的工具,可以接着看我们的 AI 编程 Agent 对比。
机器人案例:抓放从 58.9 秒到 17.4 秒,中间撞过盒沿
Google 的 机器人演示里,有一项可以直接看见过程的硬件任务:SO-101 机械臂把桌面的 LEGO 积木放进木盒。任务先要求识别物体、画出路径,停在不移动硬件的 dry run;之后悬停核对相机视角,再执行、回看录像并优化。
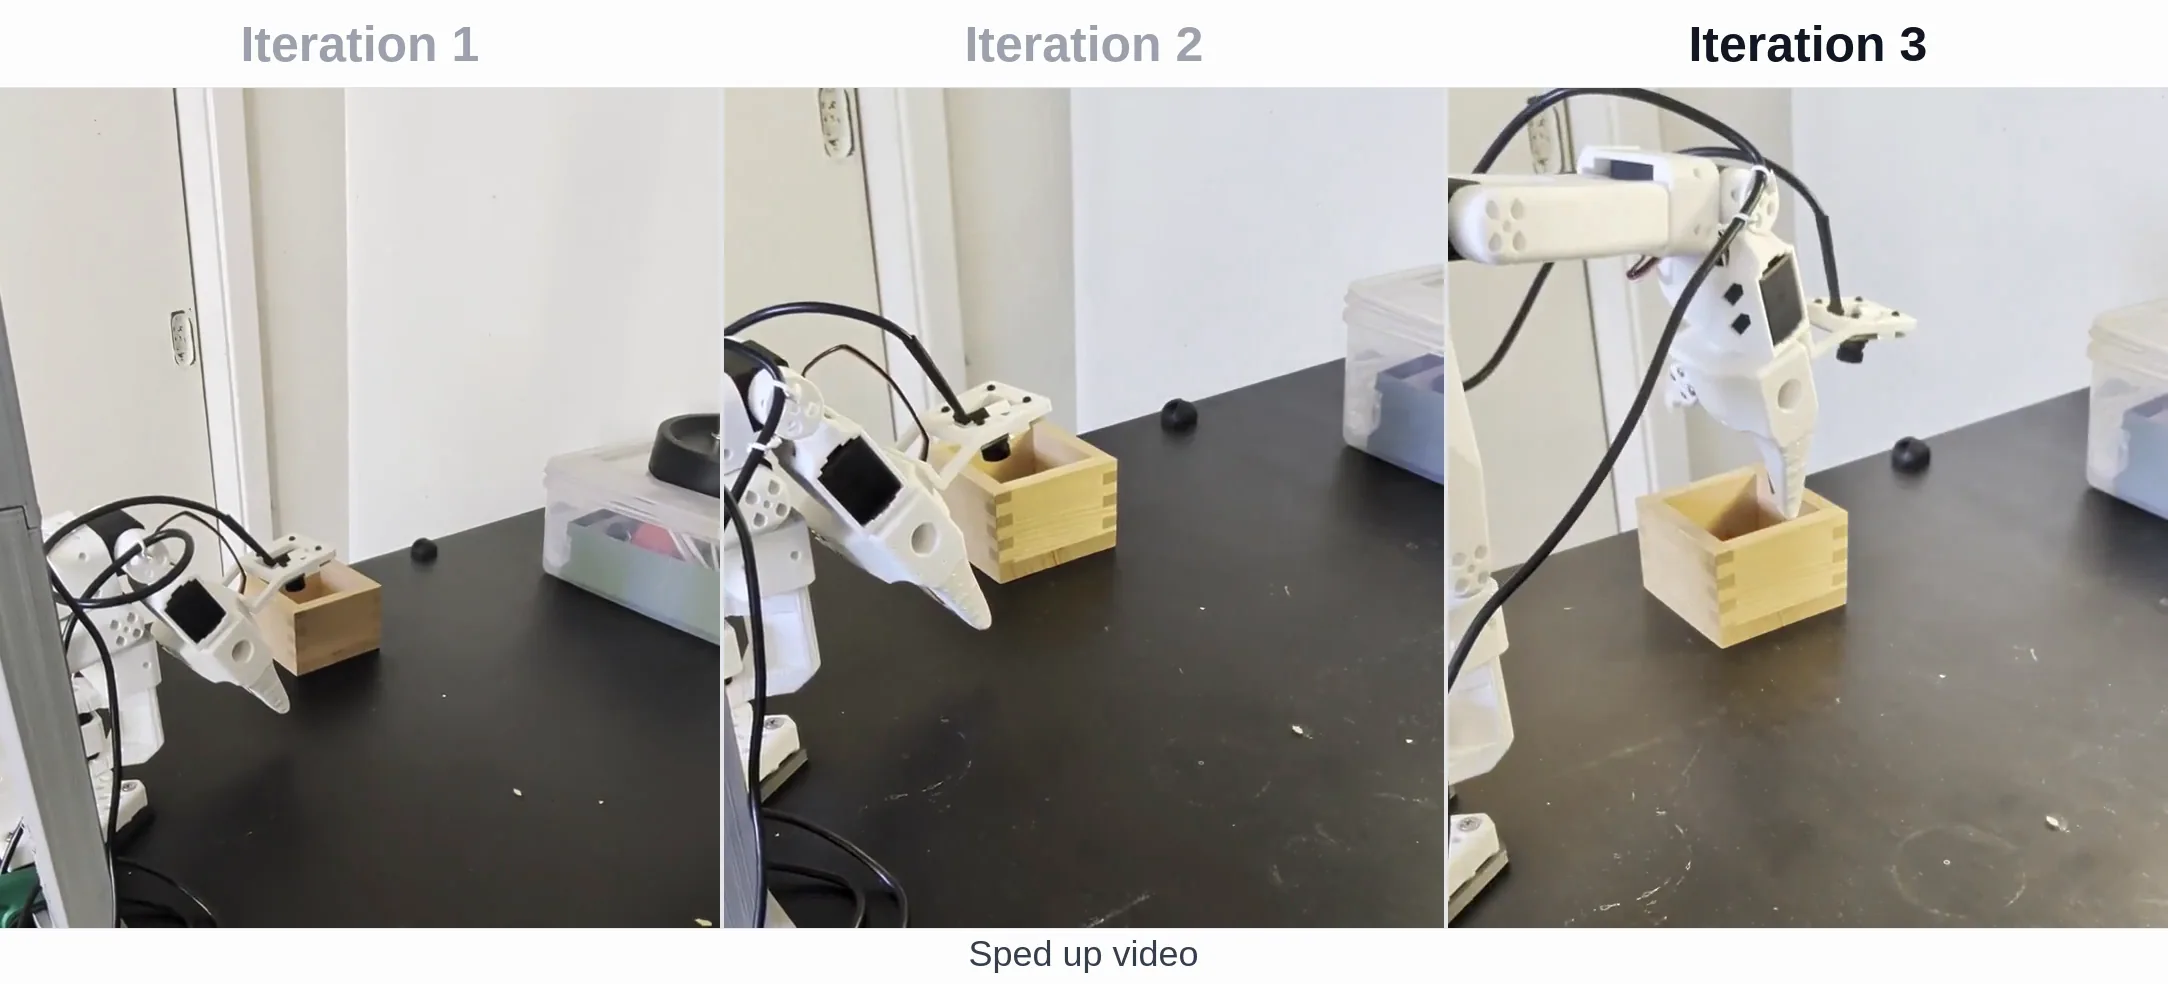
图:从 Google 原始演示视频第 31 秒提取的完整画面,保留“Speed up video”标注。下表耗时来自官方案例描述,不能用这段加速回放自行计时。
| 执行轮次 | 官方记录的耗时 | 结果 |
|---|---|---|
| 第一次 | 58.9 秒 | 完成抓放,速度较慢 |
| 第二次 | 22.9 秒 | 放下时擦到盒沿 |
| 第三次 | 17.4 秒 | 放到盒子中央 |
这里的价值是修正过程有迹可循:速度变快后出现了放置偏差,下一轮再改善。它仍是一段特定设备、场景和任务的演示;Google 没有在这一项里给出多次随机摆放的总体成功率。三次耗时不能直接换算成“所有机器人任务快几倍”。
视频理解案例:机器人反复重试,不等于任务在推进
同一发布文章还展示了对 136 秒双臂机器人折纸录像的事后标注。输入是现成视频,输出分为整体目标、六个子任务、17 个接触动作和质量控制信息。
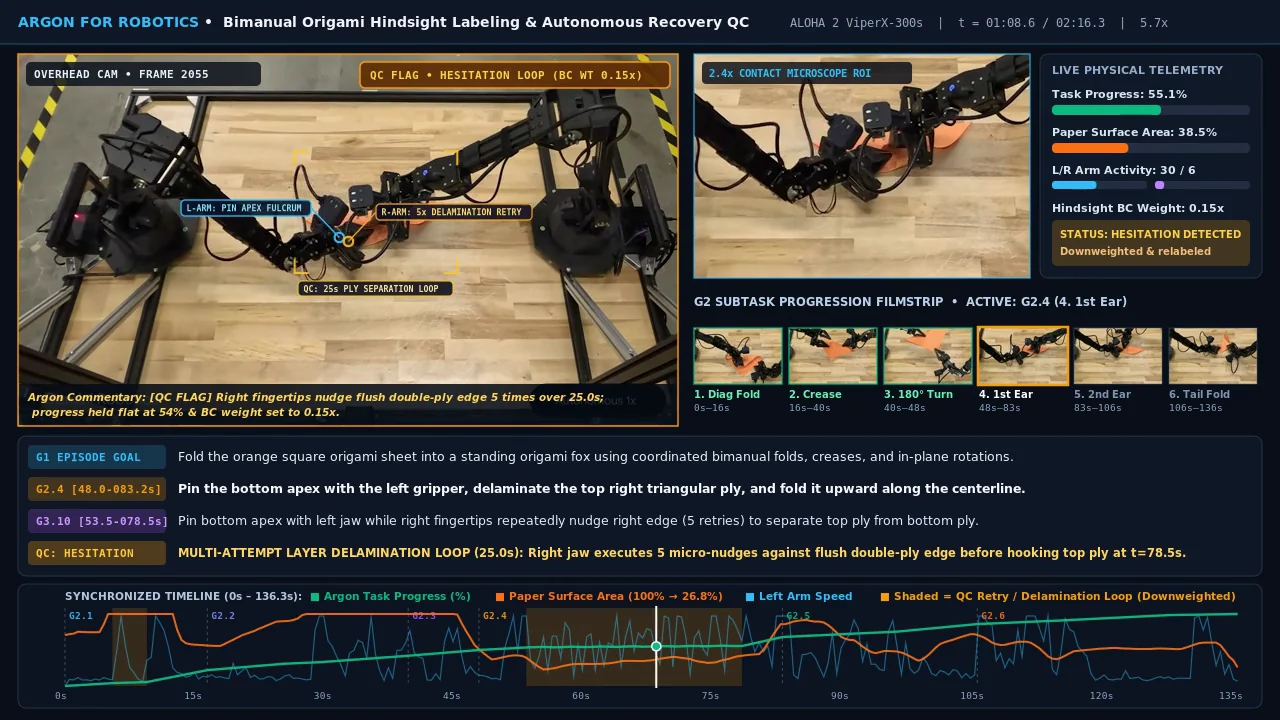
图:Google 原始标注演示第 12 秒截图,原视频已加速。黄色区段对应重复尝试,右侧显示质量控制状态和 0.15 倍权重。
与“看懂视频”相比,这个输出更容易检查:它把停顿、打滑和重试标成低质量片段,避免将反复动作算成任务进度。对机器人训练数据来说,这能提示哪些片段需要复查或降权。演示没有给出与人工标签对比的误差率,因此它展示了标注形式和一个具体例子,还不能证明所有录像都能被可靠自动标注。
以上图表与视频画面均归 Google 及相应权利人所有,本文节选用于讨论对应测试,来源已在图下注明;图片仅作 WebP 转换,视频画面未改写结果。
Gemini 4 Argon 在哪里能用?Pro 和 Ultra 的区别
先按你要做的事选择入口,再看账号条件。
| 入口 | 本次官方确认的条件 | 适合做什么 |
|---|---|---|
| Gemini App | Google AI Pro、Ultra | 聊天、分析资料、交办任务 |
| Google AI Studio | 开发者发布文章明确列出 Ultra 订阅用户 | 在网页中试提示词、查看模型输出 |
| Gemini API | Gemini API 付费层 | 接入自己的应用和 Agent |
| Google Antigravity | 开发者发布文章明确列出 Ultra 订阅用户 | 仓库开发、复杂规划和长任务 |
| Gemini for business | Google Cloud 宣布在网页、桌面和移动端开放 | 企业工作流程;具体授权看组织配置 |
来源:Gemini App 公告、Google Developers 发布文章的接入说明、Google Cloud 开放公告。
这里最容易误读的是 Pro。API 价表写着 Argon 不支持 Free tier 或 Google AI Pro plan,指的是该开发者入口的条件;Gemini App 公告则明确支持 Pro。两条信息需要放回各自的产品里读。App 订阅权限也不能替代 API 项目的付费配置。
如果你的目标只是用 Argon 对话,可以先到 Gemini App检查模型选择器。准备开发集成时,再确认 AI Studio 中项目的计费状态和可用模型。公告确认了开放范围,具体账号仍以当前界面、地区支持和项目权限为准。
API 怎么调用?正式模型 ID 是 gemini-4-argon
官方模型页已经列出稳定模型标识 gemini-4-argon。不必再从桌面客户端字符串或第三方模型列表推测名字。
官方快速开始使用 Interactions API。这是一个能保存会话状态、跟踪执行进度和运行后台任务的接口。原有集成可以按官方迁移说明逐项调整,尤其要检查 SDK 是否支持 interactions。
在服务端安装或更新 google-genai,配置付费项目的 GEMINI_API_KEY 后,可以用下面的 Python 示例发起普通请求:
这是普通文本请求,不会自行读取你的仓库;要分析代码,需要把相关内容作为输入提供。API Key 留在服务端环境变量里。示例核对了官方接口和 Python 语法,没有实际发出计费请求。
迁移时还有三个小地方值得一起改。Argon 不支持旧式显式缓存,应移除 cached_content 或创建缓存对象的调用;temperature、top_p、top_k 即使传入也会被忽略;多轮会话可以通过 previous_interaction_id 续接。默认保存请求的行为和保留期限,见 Interactions API 的数据说明。
百万 tokens 输出怎么开?先分清窗口和请求上限
“能输出一百万 tokens”不等于每个请求默认都能写到一百万。模型规格规定,输入、思考和输出共享 1,048,576 tokens 的窗口。输入占得越多,留给后面生成的空间就越少。
Long decode 文档把请求条件写得很具体:
- 普通同步请求,包括流式请求,上限是 65,536 tokens。
- 开启
background=True,但不提高输出上限,仍然停在 64K。 - 要超过 64K,必须同时启用后台执行,并将
max_output_tokens设为大于 65,536 的值,且不能超出剩余窗口。
在普通请求里直接填写更大的上限,当前会得到 400 错误。这是接口条件,不是换个 high 推理档位就能解决的问题。
后台长输出按最多 64K 的分段继续生成,每一段都会添加一个 model_output step。拿到最终结果时,需要合并这些 steps 的文本,不能只取最后一段。后台执行指南说明了任务 ID、状态查询和断开后重新连接的方式。
长任务接入时,建议先保存 interaction ID,再决定怎样展示进度和处理失败。页面刷新后能找回原任务,会比重新提交同一份大输入更实用。只有任务确实被 64K 限制截断时,再考虑 long decode;一般分析和代码修改先用较小预算试起来。
API 价格:优惠到 11 月 30 日,思考 tokens 也收费
这次不再需要猜优惠何时结束。官方价表已明确,标准 API 首发费率有效至 2026 年 11 月 30 日,12 月 1 日起切换常规价格。下表单位均为美元/百万 tokens。
| 标准 API 计费项 | 至 11 月 30 日 | 12 月 1 日起 |
|---|---|---|
| 未缓存输入 | $2 | $4 |
| 输出,含思考 tokens | $10 | $20 |
| 命中的隐式缓存输入 | $0.10 | $0.20 |
缓存折扣只适用于实际命中的输入;不能因为提示词重复,就把全部输入按缓存价预算。Batch 和 Flex 的输入/输出费率在优惠期为 $1/$5,之后为 $2/$10;它们的运行条件也需要单独核对。
举个假设账单:一项任务有 10 万未缓存输入 tokens,最终正文用了 1 万 tokens,另外用了 3 万思考 tokens。按标准优惠费率,费用是 0.1 × $2 + 0.04 × $10 = $0.60;12 月起相同用量为 $1.20。这里没有计入搜索工具、重试或其他附加费用。
模型只显示一份短答案,后台仍可能用了不少思考 tokens。对长推理任务,预算应看计费 usage,而不只看屏幕上的文字长度。试点结果也应同时按优惠和常规费率算一次,避免团队刚接好,预算就变了。
low、medium、high 怎么选?从 medium 开始
Argon 支持 low、medium、high 三个思考档位,默认是 medium。开发者指南将 medium 推荐给多数任务,包括复杂代码和 Agent 使用;high 会用更多 tokens,首个 token 的等待也更长。
如果要检查一个小补丁、整理一份资料,可以先用 medium,再试 low 是否足够。只有遇到难以定位的跨文件问题、复杂数学或科学任务时,再比较 high 带来的结果是否值得多等、多付费。
还要检查 Agent 框架里是否残留很小的输出上限。max_output_tokens 约束思考与输出总量,旧配置里的 8K 可能让模型思考完就没有多少空间回答。降低推理档位和放宽输出上限,解决的是两件不同的事。
常见问题
Gemini 4 Argon 可以免费用吗?
官方 API 价表明确 Free tier 不支持 Argon;Gemini App 开放公告确认的是 Pro 和 Ultra。本文没有找到免费账号获得 Argon 的官方承诺,不把试用优惠或第三方渠道当作免费层权限。
Argon 能直接生成图片、视频或音频吗?
模型页支持文字、图片、视频、音频和 PDF 输入,输出是文字;图片生成、音频生成和 Live API 均标为不支持。理解视频、写图形代码和直接生成视频是不同能力。
为什么开了 high,输出还是没有超过 64K?
high 控制推理深度,long decode 控制超过 64K 的生成方式。还需要后台执行和更大的 max_output_tokens,并确认输入没有占满统一窗口。只提高推理档位不会自动开启长输出。
我应该现在把所有请求都切到 Argon 吗?
先选一项目前完成得不好的真实任务:一个跨文件故障、一份需要核对表格与出处的文档,或一项会中断的长流程。用现有模型和 Argon 各跑一次,记录验收结果、等待时间与计费 usage。日常请求如果已经完成得很好,就没有必要只因为新模型开放而全部更换。