
看到 Gemini 4 Argon 的发布消息,先确认自己的账号能不能用。跑分可以帮你决定测试什么,却不能替你开通权限,也不能说明一次长任务最终要花多少钱。
本文核对了 Google 公告、评估方法和 Artificial Analysis 的独立结果,资料检查日期为 2026 年 10 月 1 日。我们没有另做一轮受控模型调用实验;文中的实测数字均标明评估方,迁移建议则是基于这些证据的编辑判断。
10 月 14 日更新: 已补充正式开放、模型 ID、API 价表和统一窗口条件;下方首发评测与图表仍保留原来的评估日期。接入步骤和入口权限见 Argon 正式开放指南。
Gemini 4 Argon 是什么,现在能用吗?
Google 在 2026 年 9 月 30 日公布 Argon,主要面向复杂编程、专业工作和防御性安全任务。最初公告采用受控开放方式;10 月 13 日的 Gemini App 公告已确认 Pro 和 Ultra 可以使用 Argon。
App 订阅、AI Studio 与 API 项目仍有各自的条件。需要集成的开发者应核对项目付费配置,不能把 App 的 Pro 权限直接套到 API 上。
10 月 1 日我们检查时,公开文档尚无 Argon 条目;现在官方模型页和价表已经补齐。正式稳定模型 ID 是 gemini-4-argon,API 使用付费层。
调用示例、后台 long decode 和缓存迁移条件见 Argon 接入补充。本文继续侧重能力评估和选型。
如果现在就要交付一个可用的 Gemini 集成,可以先看我们的 Gemini 3.8 Flash API 指南。它是另一个模型,不能把它的开放状态套到 Argon 上。
Gemini 4 Argon API 价格:别只按首发优惠做预算
以下是正式 API 价表中的标准费率,单位为美元/百万 tokens。首发优惠有效至 2026 年 11 月 30 日,12 月 1 日起使用常规费率。
| 计费项 | 首发优惠价格 | 优惠结束后 |
|---|---|---|
| 未缓存输入 | $2 | $4 |
| 输出,含思考 tokens | $10 | $20 |
| 命中的隐式缓存输入 | $0.10 | $0.20 |
来源:Google API 价表。Argon 只支持隐式缓存,缓存价格适用于实际命中的输入;工具调用及其他费用另行核对。
用一个假设例子看差别:某次请求计费 10 万未缓存输入 tokens、1 万输出 tokens,没有其他费用,首发价格下是 $0.30,计算式为 0.1 × $2 + 0.01 × $10。相同用量按后续费率是 $0.60。如果这 10 万输入全部按缓存命中计费,首发账单则为 $0.11,尚未包括可能单独收取的缓存费用。
做试用预算时,建议保留两列:今天实际花了多少,以及相同用量按优惠结束后的价格会花多少。否则试点看起来划算,可能只是暂时折扣起了作用,模型质量没变,成本优势却消失了。
还要把失败重试算进去。用全部模型支出除以验收通过的任务数,再单独记录人工修正时间。一份便宜但要花很久返工的补丁,和一份可以合并的补丁,不是同一种结果。
官方跑分怎么读:优势明确,也有落后的项目
DeepMind 的公开比较表呈现的是一组有强有弱的能力。这里挑出与实际选型相关的项目,不把不同测试的百分比混在一起求平均。
| 评估项目 | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 66.4% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| GraphWalks,256K–1M,BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
这是 Google 发布的汇总,其中既有 Google 自测,也有外部评估机构的数据。它不是一次对所有模型统一条件、独立复现的实验。
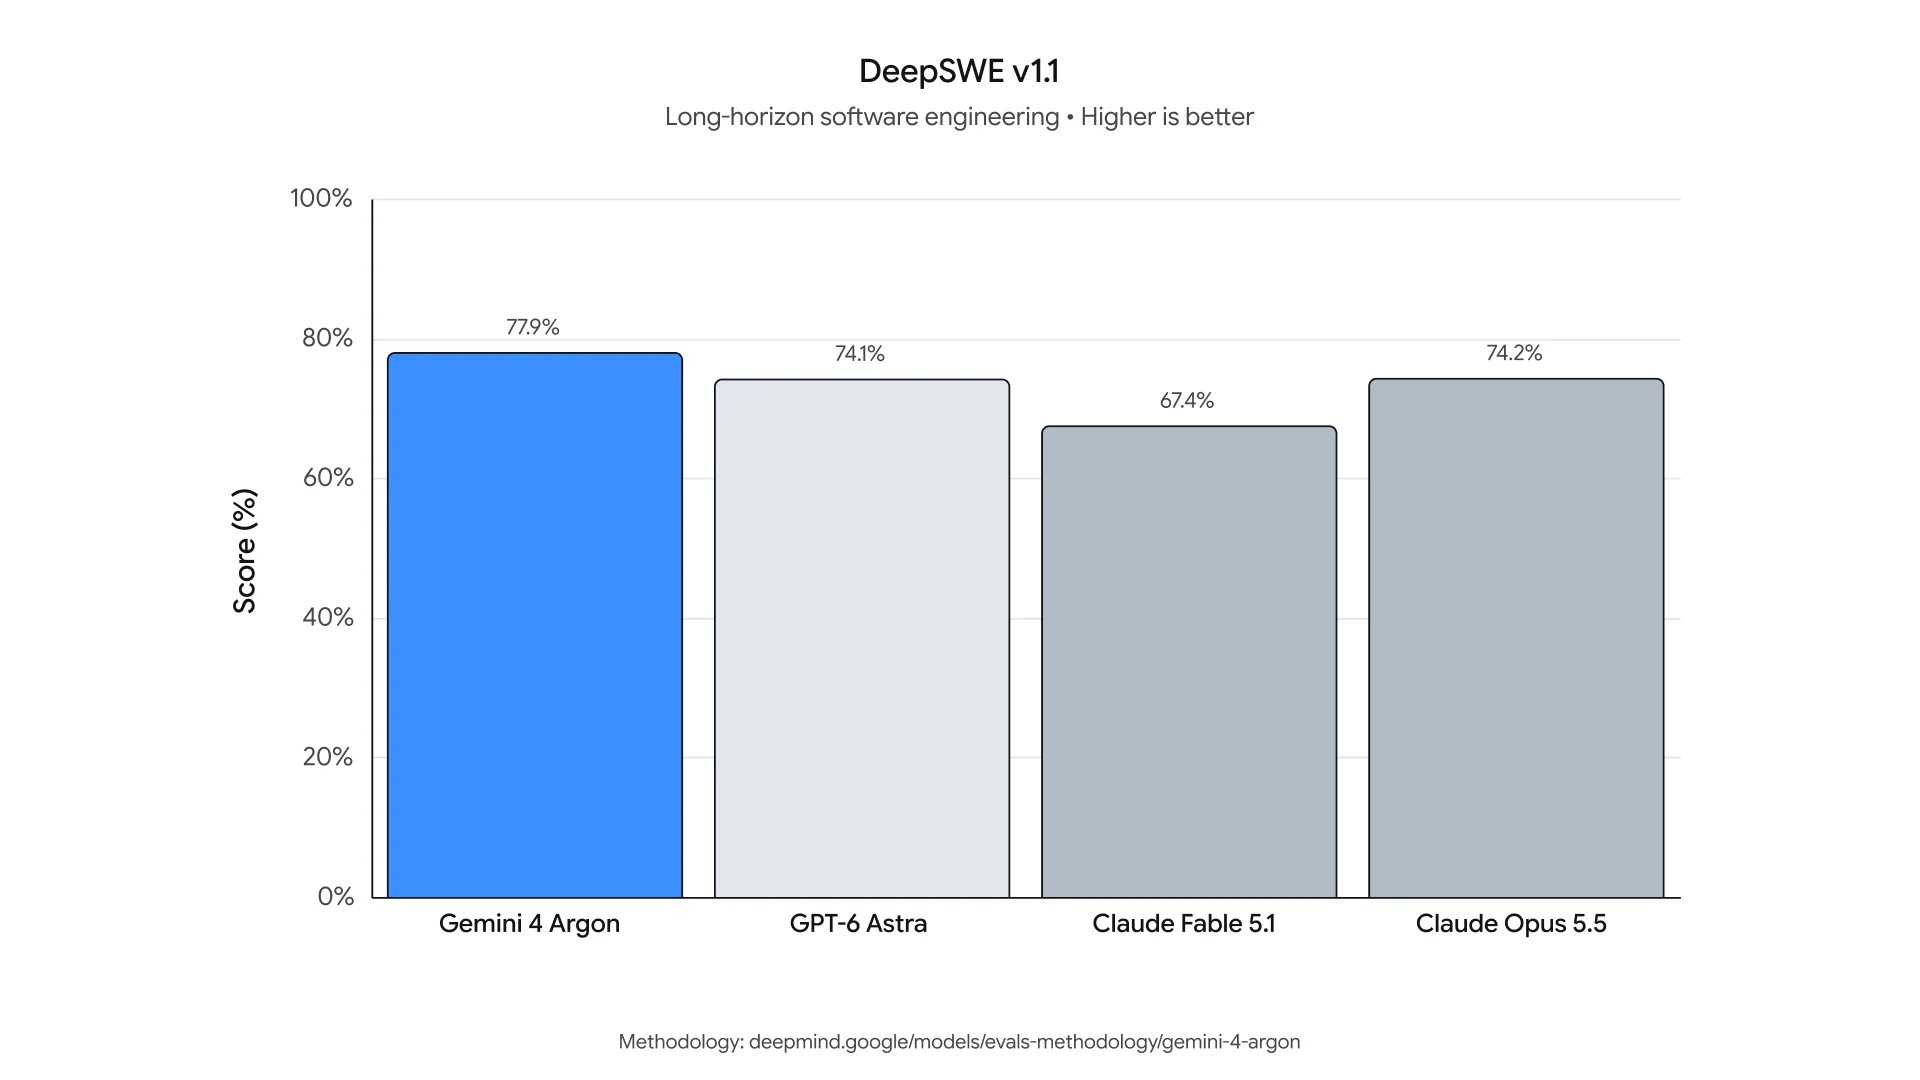 图来自 Google 发布公告。Agent 框架和推理设置也是成绩的一部分。
对开发者来说,DeepSWE 与 FrontierSWE 的反差很值得看:Argon 在一组工程问题里领先,换另一组,Astra 就占了上风。它们都属于编程评估,但没有哪一行能直接回答,谁更懂你的构建系统、谁能定位你的回归问题、谁会保留没有写进文档的约束。
评估方法文档补充了影响解释的条件:Argon 通常使用最高思考设置和 pass@1;DeepSWE 的 Argon 成绩由 Google 用 mini-swe 框架计算;视频测试给不同模型的帧预算不同。OSWorld 离线成绩是部分得分,还有自己的运行选择规则。比较时不能丢掉这些条件。
GraphWalks 的成绩可以支持你去测试大输入里的依赖追踪,却不能代表所有合同、表格或 RAG 系统的准确率。视频任务也应检查具体时刻:回答引用的时间戳是否正确,证据是否真的出现在那一帧里。跑分高,并不免除这一步验收。
独立测评:和 Astra 比划算,和 Sol 比是另一回事
Artificial Analysis 的首发评估给 Argon 的 high 档 53 分,指标为 Intelligence Index v4.3.2;Astra 的 max 档也是 53 分,Sol 6.1 的 max 档是 52 分。这是综合指数分数,不是回答正确率。
这组评估的平均任务成本分别是 Argon $1.99、Astra $3.26、Sol 6.1 $0.72。保持 token 用量不变,改用优惠结束后的费率,Argon 将变成 $3.98。这是特定评估任务组合下的价格情景,不是对你的生产账单的预测。
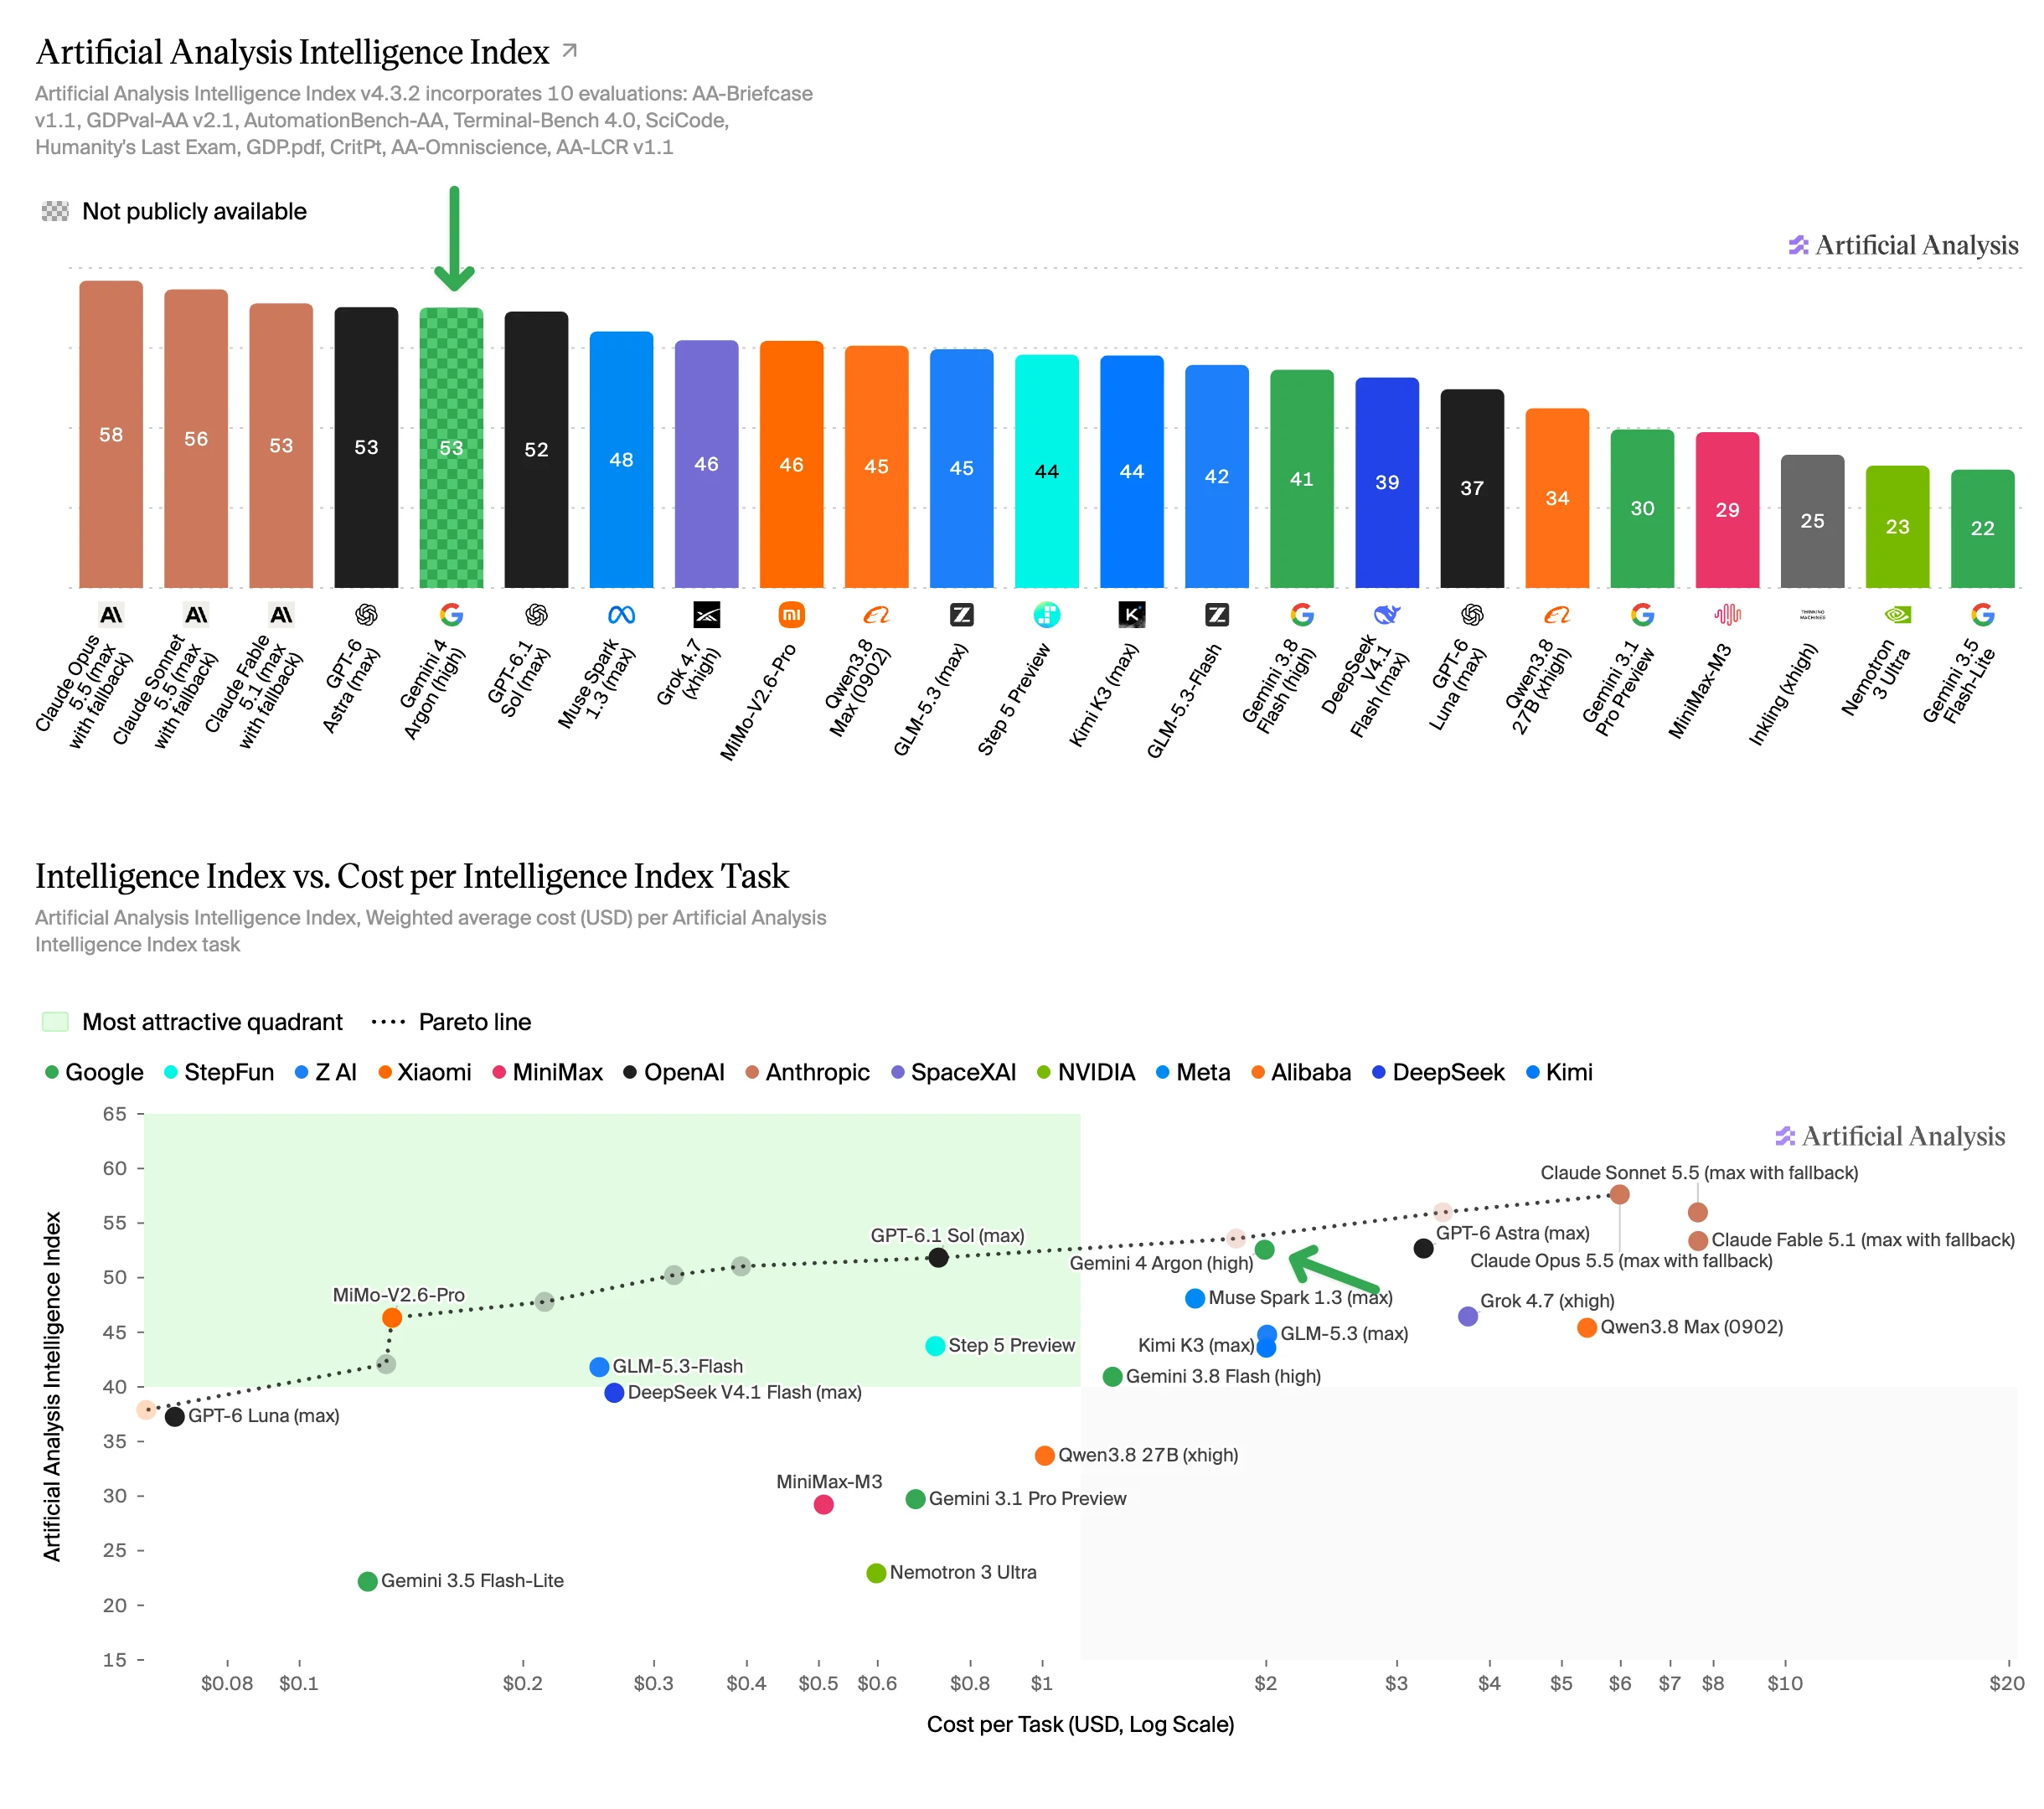 图来自 Artificial Analysis 独立首发评估。开放标注反映首发时点,当前权限见前文;推理档位和部分模型的 fallback 配置保留原样。
这会改变选型结论。如果你的工作流目前靠较贵的 Astra 完成,Argon 在优惠期值得试;如果你已经用 Sol 6.1,综合分数只提高一点,评估账单却明显增加。我们的 Sol 6.1 评测也强调,要把推理档位和每个验收结果的成本一起测。
具体任务同样会影响判断。AutomationBench-AA 的独立评估页给 Argon high 的显示成绩是 77.5%。这个主要指标计算完成的目标占比,任务只要违反护栏规则,该任务就记零分;它不是全部任务完整完成的比例。因此,不能把它与 Google 汇总表中的 51.3% 当成同一个指标读。评估方、设置、数据集和评分规则都需要随数字一起保留。
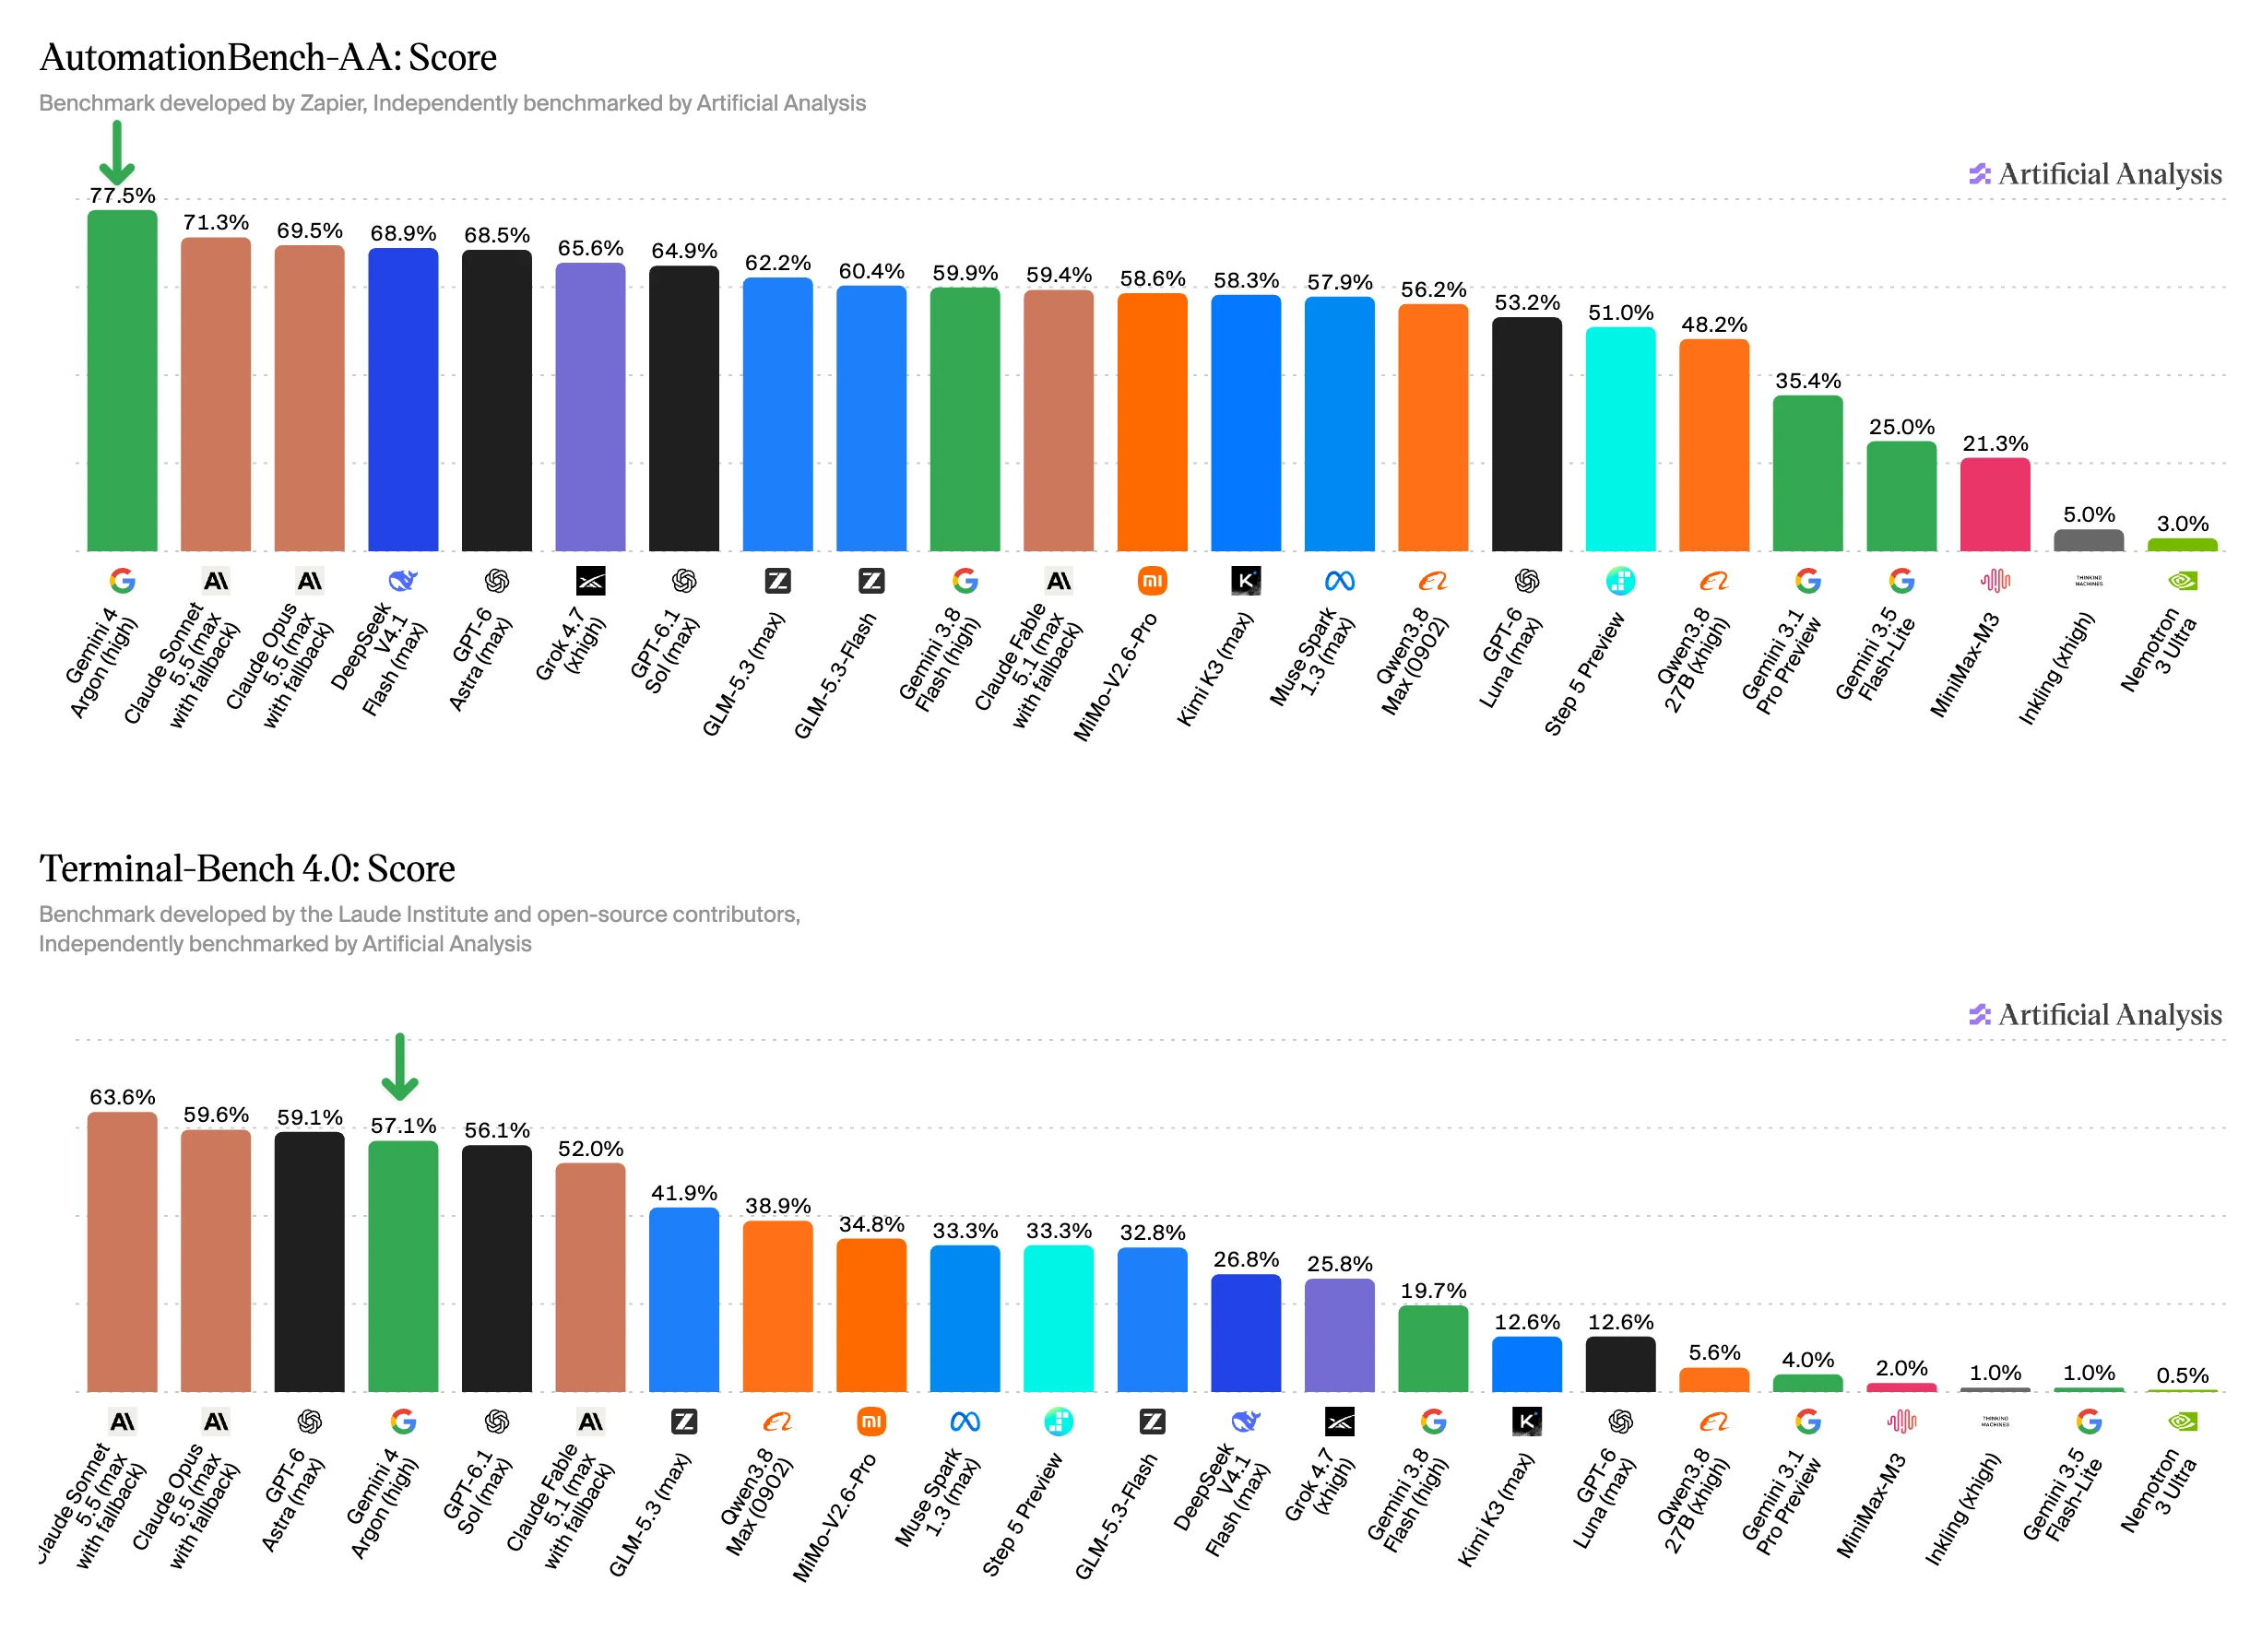 图来自 Artificial Analysis。它有助于区分独立 SaaS 工作流测试和 Google 的汇总数据。
模型评估页记录了整个智能指数测试使用 1.1 亿输出 tokens,同时没有公开的输出速度实测值。长推理可能帮助完成问题,但等待时间、取消操作和失败恢复仍要自己测试。现有资料不足以把 Argon 称为“速度很快”的模型。
百万输出 tokens,改变的是长任务怎么运行
更新后的模型文档明确:输入、思考和输出共享 1,048,576 tokens 的窗口。普通同步请求上限为 65,536 tokens;超过 64K 需使用后台 long decode,并提高输出预算。
更实际的问题是,一次很长的运行中断后怎么办。应用能否重新连接、保存进度、避免重复执行工具动作?Artificial Analysis 首发评估使用了 Long Decode Continuation;现在可结合官方长输出指南核对后台参数、续接与结果合并条件。
任务确实需要时,更长的上限有价值。但它也可能带来更大的账单,或者一段很长却没有满足验收条件的调查。先规定交付物:补丁和检查结果、带出处的备忘录、公式经过验证的导出文件。让模型处理难题之前,先设好时间与费用上限。
可靠性与网络安全:数字之外,还有适用条件
Artificial Analysis 报告 Argon high 在 AA-Omniscience 的幻觉率为 15%,准确率为 50%。两者分母不同。指标定义说明,准确率按全部问题计算;幻觉率则是错误回答占“错误、部分回答、未作答”总数的比例。所以 15% 幻觉率不等于“写出来的内容有 85% 正确”。
测试文档任务时,可以专门留一个缺失数字,让模型给出带出处的结论。看它会说明证据缺失、编一个合理数字,还是悄悄换掉问题。团队日常用中文,就再用中文验收一次;这些基准不能直接证明中文写作质量。
Fairwind Program是防御性安全能力的受控开放路径。Google 公告区分了可信防御者的网络安全配置和面向更广用户的防护措施。它没有承诺普通 API 用户会拿到同样的配置,也没有证明提示注入已经解决。
工程团队的验收条件仍应包括补丁正确性、回归检查和人工审查。检索材料里不要混入机密,工具权限按任务收紧。模型越能做事,一次错误操作的影响也可能越大。
值不值得迁移,建议用这三类任务决定
让候选模型先证明自己,再替换生产里的现有模型。我们建议做三部分试验:
- 仓库问题: 给两个系统同一个已知故障、仓库状态和检查命令。修好问题、保住已测试行为后才接受补丁,并记录重试次数与审查时间。
- 专业文档: 使用同一份 PDF、表格或图表,要求带出处的决策备忘录,再加入一个明确缺失的事实。检查单位、日期和无证据结论,不只看文字顺不顺。
- 多步工作流: 在有限权限下要求一个真实保存的交付物。核对最终记录或导出,再测试中断恢复。分别按优惠期和后续费率计算总成本。
尽量固定 Agent 框架、工具和权限。如果它们与模型一起变了,就把结果记为系统变化,而非纯模型比较。也要保留升级处理难题的路径;如果 Astra 仍在候选里,可以结合我们的 Astra API 指南核对接入条件。
现有证据足够支持一次认真试用。真正值得切换的时刻,是它能给出更多验收通过的结果,或者以团队在优惠结束后仍能承担的成本,完成同样合格的工作。
常见问题
免费用户或 Google AI Pro 用户能用 Gemini 4 Argon 吗?
10 月 13 日官方已确认 Gemini App 的 Pro 和 Ultra 权限;API 价表明确不支持 Free tier。AI Studio、Antigravity 和 API 条件不同,详见入口权限表。
接入 API 应该填写哪个模型 ID?
当前官方模型页已经确认稳定模型 ID 为 gemini-4-argon。接入时仍应核对项目付费层和账号权限。
百万输出上限,是不是也能输入百万 tokens?
输入、思考和输出共享一个 1,048,576 tokens 窗口;不能同时把输入和输出都用到一百万。普通同步输出为 64K,长输出需要后台 long decode。
首发 API 优惠什么时候结束?
正式价表已明确优惠至 2026 年 11 月 30 日,12 月 1 日起标准 API 为每百万输入 $4、输出 $20,命中的隐式缓存输入 $0.20。输出计费包含思考 tokens。